

ट्रांसक्रिप्शन सेटिंग्स
ट्रांसक्राइब करने से पहले Audiotext ट्रांसक्रिप्शन की सेटिंग्स कार्डों में समूहित करके दिखाता है। ये अगली बार के लिए याद रखी जाती हैं, और हर ट्रांसक्रिप्शन उन सेटिंग्स को सहेजता है जिनसे वह बनाया गया था।
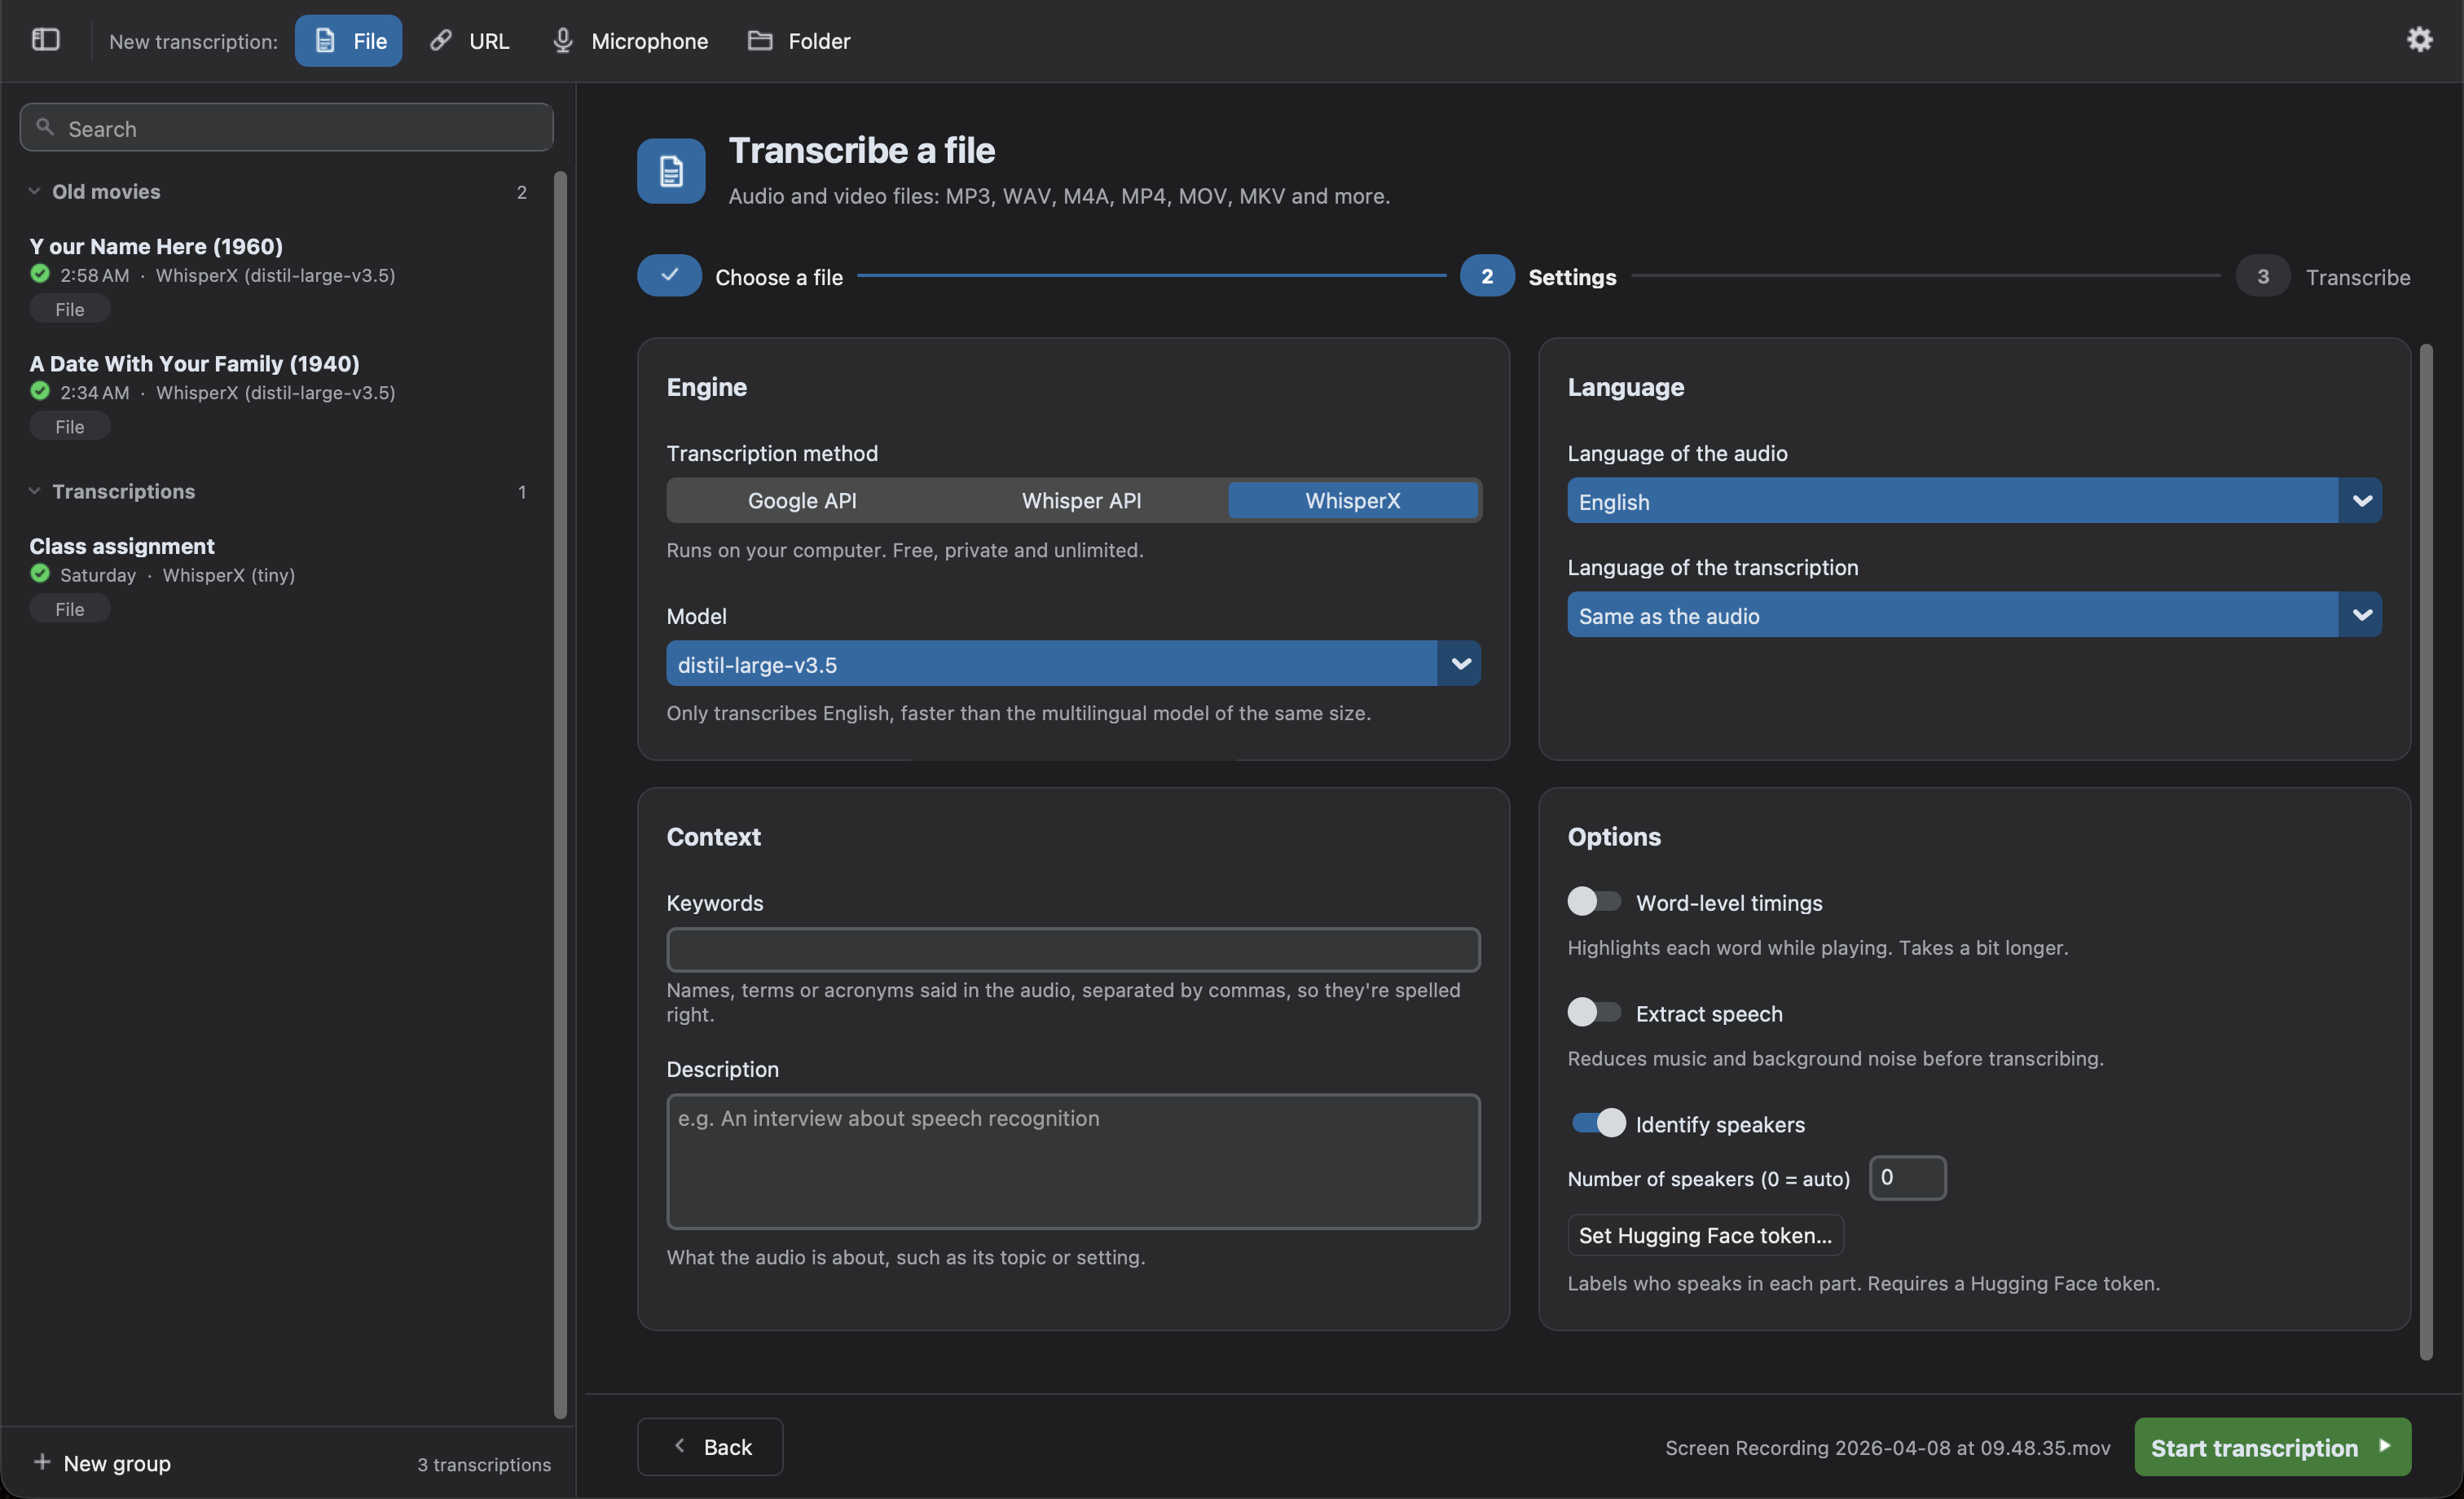
ट्रांसक्रिप्शन विधि:
| इंजन | कहाँ चलता है | लागत | टिप्पणियाँ |
|---|---|---|---|
| WhisperX (डिफ़ॉल्ट) | आपका कंप्यूटर | मुफ़्त और असीमित | निजी और ऑफ़लाइन। ज़्यादा विकल्प: वक्ता, शब्द-स्तरीय समय, लाइव टेक्स्ट। Apple Silicon वाले Mac के GPU पर चलता है। |
| Whisper API | OpenAI के सर्वर | प्रति मिनट भुगतान | OpenAI API कुंजी आवश्यक। उन कंप्यूटरों के लिए जो WhisperX को सुचारु रूप से नहीं चला सकते। |
| Google API | Google के सर्वर | मुफ़्त टियर या भुगतान | कम गुणवत्ता और टाइमस्टैम्प नहीं। API कुंजी वैकल्पिक है। |
मॉडल इंजन पर निर्भर करता है। WhisperX में बड़े मॉडल ज़्यादा सटीक, लेकिन धीमे होते हैं। Whisper API में यह तय करता है कि ट्रांसक्रिप्शन में टाइमस्टैम्प और वक्ता होंगे या नहीं। तुलना के लिए इंजन देखें।
- ऑडियो की भाषा: डिफ़ॉल्ट रूप से स्वतः पहचानें। इसे चुनने से छोटे या मिश्रित ऑडियो में गलतियाँ कम होती हैं। Google API भाषा नहीं पहचान सकता, इसलिए उसके लिए इसे चुनना ज़रूरी है।
- ट्रांसक्रिप्शन की भाषा: डिफ़ॉल्ट रूप से ऑडियो के समान। ट्रांसक्राइब करते समय ऑडियो का अनुवाद करने के लिए कोई दूसरी भाषा चुनें।
जब दोनों भाषाएँ अलग हों, तो अनुवाद के विकल्प दिखते हैं:
- Whisper से अनुवाद करें (अनुशंसित): Whisper एक ही चरण में ऑडियो ट्रांसक्राइब और अनुवाद करता है। यह केवल अंग्रेज़ी में अनुवाद कर सकता है।
- सीधे भाषा में लिखें (प्रयोगात्मक): Whisper से ट्रांसक्रिप्शन को सीधे उस भाषा में लिखने को कहा जाता है। यह कई भाषाओं में अच्छा काम करता है, लेकिन नतीजा जाँच लें।
Google API अनुवाद नहीं कर सकता। बाद में किसी भी भाषा में, ज़्यादा प्रदाताओं के साथ अनुवाद करने के लिए, ट्रांसक्रिप्ट के अनुवाद करें बटन का उपयोग करें।
संदर्भ
Section titled “संदर्भ”दो वैकल्पिक फ़ील्ड जो मॉडल की मदद करते हैं:
- कीवर्ड: ऑडियो में बोले गए नाम, शब्द या संक्षिप्त रूप, कॉमा से अलग किए हुए (जैसे
Audiotext, WhisperX, Henestrosa), ताकि उनकी वर्तनी सही हो। ये केवल संकेत हैं: कोई कीवर्ड तभी लिखा जाता है जब वह ऑडियो में बोला गया हो। - विवरण: ऑडियो किस बारे में है, जैसे उसका विषय या परिवेश (जैसे
वाक् पहचान पर एक इंटरव्यू)।
इनका उपयोग WhisperX और Whisper API करते हैं, gpt-4o-transcribe-diarize मॉडल को छोड़कर। Google API इनका उपयोग नहीं करता।
विकल्प
Section titled “विकल्प”- शब्द-स्तरीय समय (WhisperX): चलाते समय हाइलाइट करने और उन शब्दों की समीक्षा के लिए जिन्हें लेकर यह सबसे कम आश्वस्त है, हर शब्द को ऑडियो से संरेखित करता है। थोड़ा ज़्यादा समय लगता है। डिफ़ॉल्ट रूप से चालू। सबटाइटल को शब्दों के समय की ज़रूरत होती है, इसलिए जब तक किसी फ़ोल्डर के फ़ाइल प्रकार में
.srtया.vttचुना हो, यह विकल्प चालू और लॉक रहता है; उनके न चुने रहने पर आपकी अपनी पसंद लौट आती है। - पृष्ठभूमि शोर कम करें: ट्रांसक्राइब करने से पहले भिनभिनाहट और लगातार पृष्ठभूमि शोर को कम करता है, और धीमी आवाज़ को बराबर करता है। इसमें ज़्यादा समय लगता है।
- वक्ताओं की पहचान करें (WhisperX): हर हिस्से में कौन बोल रहा है, यह लेबल करता है, जैसे
SPEAKER_00। अगर आप जानते हैं कि कितने लोग बोलते हैं, तो उसे वक्ताओं की संख्या में दर्ज करें (0अपने-आप पहचानता है)। इसके लिए मुफ़्त Hugging Face टोकन चाहिए; वक्ताओं की पहचान देखें। Whisper API मेंgpt-4o-transcribe-diarizeमॉडल वक्ताओं की पहचान करता है।
वक्ताओं की पहचान
Section titled “वक्ताओं की पहचान”वक्ताओं की पहचान करने वाला मॉडल, pyannote/speaker-diarization-community-1, मुफ़्त है, लेकिन इसके लिए Hugging Face टोकन चाहिए:
- Hugging Face पर खाता बनाएँ और pyannote/speaker-diarization-community-1 की शर्तें स्वीकार करें।
- अपनी सेटिंग्स में
Readभूमिका वाला टोकन बनाएँ। - Hugging Face टोकन सेट करें… पर क्लिक करें और उसे चिपकाएँ।
मॉडल पहली बार उपयोग होने पर डाउनलोड होता है। उसके बाद वक्ताओं की पहचान ऑफ़लाइन होती है।
लाइव टेक्स्ट
Section titled “लाइव टेक्स्ट”केवल माइक्रोफ़ोन के लिए दिखता है। लाइव टेक्स्ट देखें।
फ़ोल्डर और आउटपुट
Section titled “फ़ोल्डर और आउटपुट”केवल फ़ोल्डरों के लिए दिखते हैं:
- फ़ोल्डर की निगरानी करें: फ़ोल्डर की निगरानी देखें।
- फ़ोल्डर में पहले से मौजूद फ़ाइलें ट्रांसक्राइब करें (केवल निगरानी के समय): पहले उन फ़ाइलों को ट्रांसक्राइब करता है जो फ़ोल्डर में पहले से हैं और जिनका अभी तक ट्रांसक्रिप्शन नहीं है। डिफ़ॉल्ट रूप से बंद।
- सबफ़ोल्डर शामिल करें: सबफ़ोल्डरों की फ़ाइलों को भी ट्रांसक्राइब करता है।
- इनसे मेल खाने वाली फ़ाइलें छोड़ें: छोड़ी जाने वाली फ़ाइलों के नाम या पाथ, कॉमा से अलग (जैसे
*.wav, drafts/*)। छिपी हुई फ़ाइलें हमेशा छोड़ दी जाती हैं। - फ़ाइल प्रकार: WhisperX के साथ
.txt,.srt,.vtt,.json,.tsvऔर.audमें से एक या अधिक। Whisper API के साथ फ़ाइलों का फ़ॉर्मेट (text,json,verbose_json,srtयाvtt); सबटाइटल के लिए टाइमस्टैम्प वाला मॉडल चाहिए। Google API सादा टेक्स्ट (.txt) लौटाता है। - स्थान: फ़ाइलें हर स्रोत फ़ाइल के पास सहेजी जाती हैं। उन्हें किसी दूसरे फ़ोल्डर में सहेजने के लिए बदलें… पर क्लिक करें (उसके सब-फ़ोल्डर फिर से बनाए जाते हैं), या वापस जाने के लिए स्रोत के पास पर।
जिन फ़ाइलों का पहले से ट्रांसक्रिप्शन है, वे छोड़ दी जाती हैं। उन्हें फिर से ट्रांसक्राइब करने के लिए फ़ोल्डर की फ़ाइलों के विकल्पों का उपयोग करें।
सबटाइटल के विकल्प (पंक्ति की चौड़ाई, पंक्तियों की संख्या, हाइलाइट किए गए शब्द) प्राथमिकताएँ में हैं।