

Impostazioni della trascrizione
Prima di trascrivere, Audiotext mostra le impostazioni della trascrizione, raggruppate in schede. Vengono ricordate per la volta successiva, e ogni trascrizione conserva le impostazioni con cui è stata fatta.
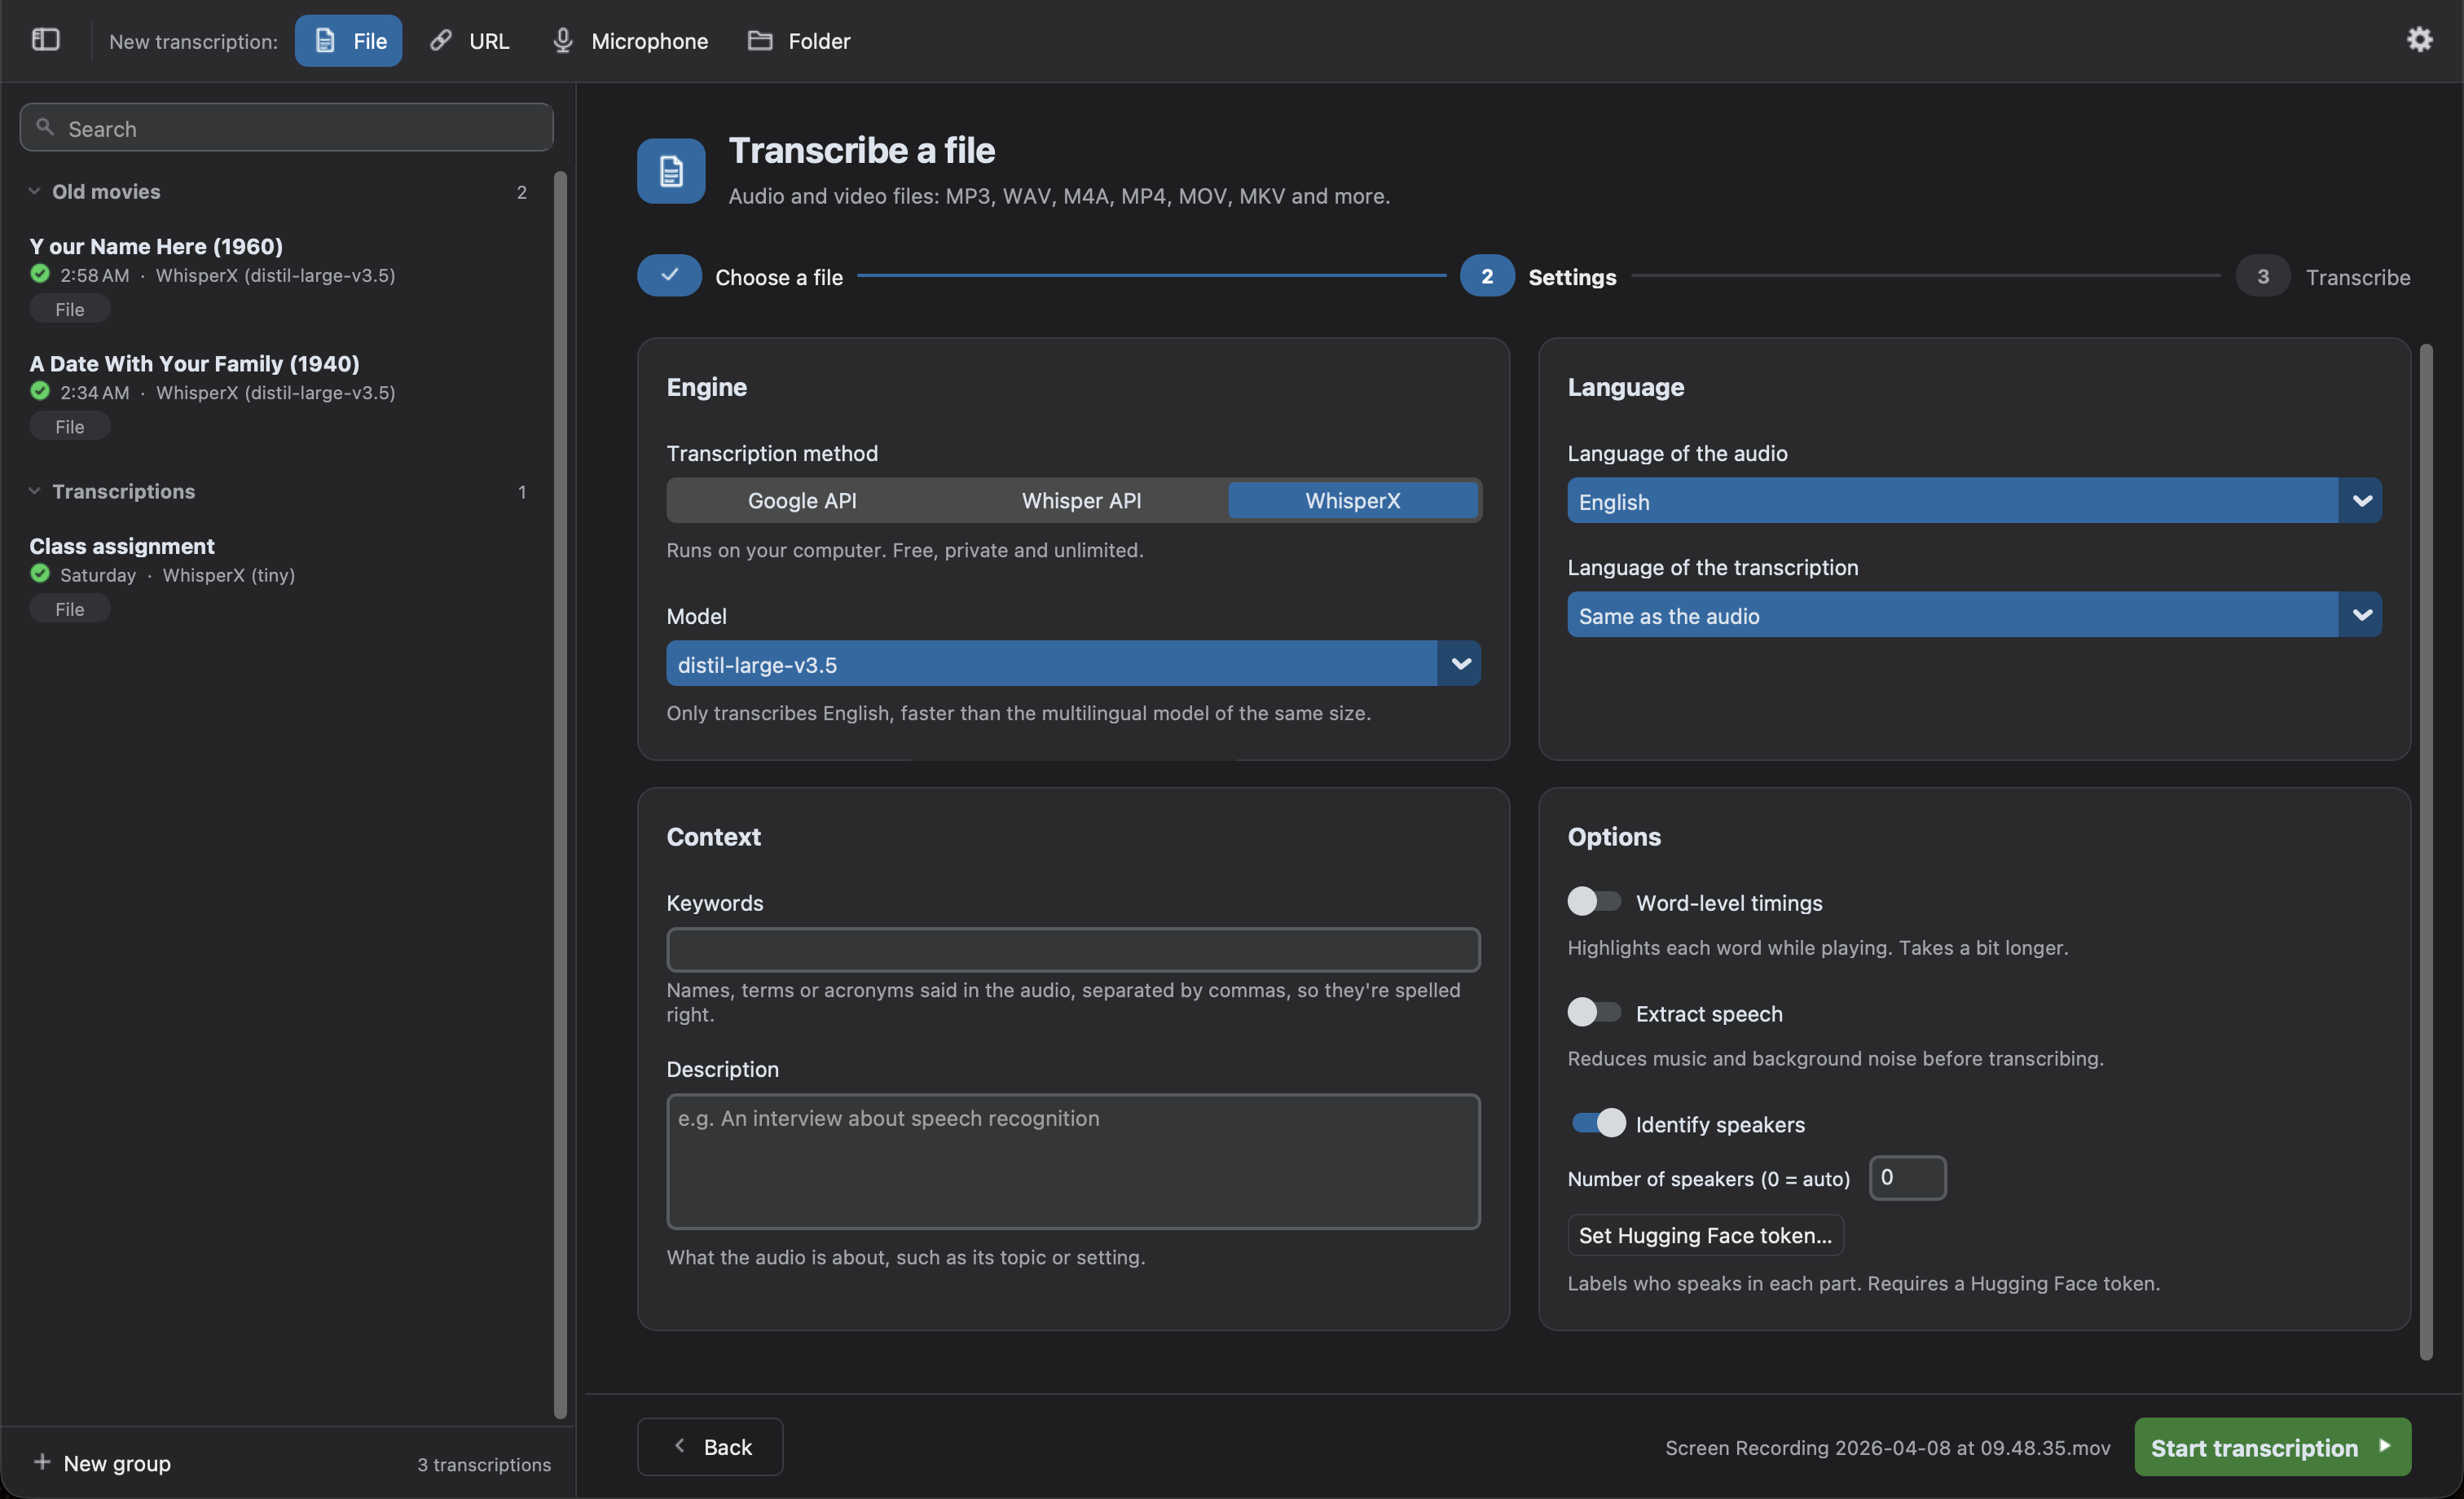
Il Metodo di trascrizione:
| Motore | Dove funziona | Costo | Note |
|---|---|---|---|
| WhisperX (predefinito) | Il tuo computer | Gratis e senza limiti | Privato e offline. Più opzioni: parlanti, tempi per parola, testo dal vivo. Funziona sulla GPU dei Mac con Apple Silicon. |
| API di Whisper | Server di OpenAI | A pagamento al minuto | Richiede una chiave API di OpenAI. Per i computer che non riescono a eseguire WhisperX in modo fluido. |
| API di Google | Server di Google | Livello gratuito, o a pagamento | Qualità inferiore e senza marcatori temporali. La chiave API è facoltativa. |
Il Modello dipende dal motore. Con WhisperX, i modelli più grandi sono più precisi, ma più lenti. Con la API di Whisper, determina se la trascrizione ha marcatori temporali e parlanti. Consulta Motori per confrontarli.
- Lingua dell’audio: Rilevamento automatico per impostazione predefinita. Sceglierla evita errori negli audio brevi o misti. La API di Google non può rilevarla, quindi devi sceglierla.
- Lingua della trascrizione: Come l’audio per impostazione predefinita. Scegli un’altra lingua per tradurre l’audio durante la trascrizione.
Quando le due lingue sono diverse, compaiono le opzioni di Traduzione:
- Traduci con Whisper (consigliato): Whisper trascrive e traduce l’audio in un solo passaggio. Può tradurre solo in inglese.
- Scrivila direttamente in lingua (sperimentale): si chiede a Whisper di scrivere la trascrizione direttamente in quella lingua. Funziona bene in molte lingue, ma controlla il risultato.
La API di Google non può tradurre. Per tradurre una trascrizione in qualsiasi lingua in seguito, con più fornitori, usa il pulsante Traduci della trascrizione.
Contesto
Sezione intitolata “Contesto”Due campi facoltativi che aiutano il modello:
- Parole chiave: nomi, termini o sigle pronunciati nell’audio, separati da virgole (es.
Audiotext, WhisperX, Henestrosa), perché siano scritti correttamente. Sono solo suggerimenti: una parola chiave viene scritta solo se è pronunciata nell’audio. - Descrizione: di cosa parla l’audio, come l’argomento o il contesto (es.
Un'intervista sul riconoscimento vocale).
Li usano WhisperX e la API di Whisper, tranne il modello gpt-4o-transcribe-diarize. La API di Google non li usa.
Opzioni
Sezione intitolata “Opzioni”- Tempi per parola (WhisperX): allinea ogni parola all’audio, per evidenziarla durante la riproduzione e per rivedere le parole di cui è meno sicuro. Richiede un po’ più di tempo. Attivo per impostazione predefinita. I sottotitoli hanno bisogno dei tempi delle parole, quindi viene attivata e bloccata mentre
.srto.vttsono scelti nei Tipi di file di una cartella; la tua scelta torna quando non lo sono più. - Riduci il rumore di fondo: riduce il ronzio e il rumore di fondo costante, e uniforma il parlato a basso volume, prima di trascrivere. Richiede più tempo.
- Identifica i parlanti (WhisperX): indica chi parla in ogni parte, es.
SPEAKER_00. Se sai quante persone parlano, indicalo in Numero di parlanti (0lo rileva). Richiede un token gratuito di Hugging Face; consulta Identifica i parlanti. Con la API di Whisper, il modellogpt-4o-transcribe-diarizeidentifica i parlanti.
Identifica i parlanti
Sezione intitolata “Identifica i parlanti”Il modello che identifica i parlanti, pyannote/speaker-diarization-community-1, è gratuito, ma richiede un token di Hugging Face:
- Crea un account su Hugging Face e accetta le condizioni di pyannote/speaker-diarization-community-1.
- Crea un token con il ruolo
Readnelle tue impostazioni. - Fai clic su Imposta token di Hugging Face… e incollalo.
Il modello viene scaricato al primo utilizzo. Dopo, i parlanti vengono identificati offline.
Testo dal vivo
Sezione intitolata “Testo dal vivo”Mostrato solo per il microfono. Consulta Testo dal vivo.
Cartella e Output
Sezione intitolata “Cartella e Output”Mostrati solo per le cartelle:
- Monitora la cartella: consulta Monitora una cartella.
- Trascrivi i file già presenti nella cartella (solo durante il monitoraggio): trascrive prima i file che la cartella contiene già e che non hanno ancora una trascrizione. Disattivato per impostazione predefinita.
- Includi sottocartelle: trascrive anche i file delle sottocartelle.
- Salta i file corrispondenti a: nomi o percorsi dei file da saltare, separati da virgole (ad es.
*.wav, drafts/*). I file nascosti vengono sempre saltati. - Tipi di file: con WhisperX, uno o più tra
.txt,.srt,.vtt,.json,.tsve.aud. Con la API di Whisper, il formato dei file (text,json,verbose_json,srtovtt); i sottotitoli richiedono un modello con marcatori temporali. La API di Google restituisce testo semplice (.txt). - Posizione: i file vengono salvati accanto a ogni file di origine. Fai clic su Cambia… per salvarli in un’altra cartella (le sue sottocartelle vengono ricreate), o su Accanto all’origine per tornare indietro.
I file che hanno già una trascrizione vengono saltati. Per trascriverli di nuovo, usa le opzioni dei file della cartella.
Le opzioni dei sottotitoli (larghezza della riga, numero di righe, parole evidenziate) si trovano nelle Preferenze.