

Transkriberingsinställningar
Innan transkriberingen visar Audiotext inställningarna, grupperade i kort. De sparas till nästa gång, och varje transkribering behåller inställningarna den gjordes med.
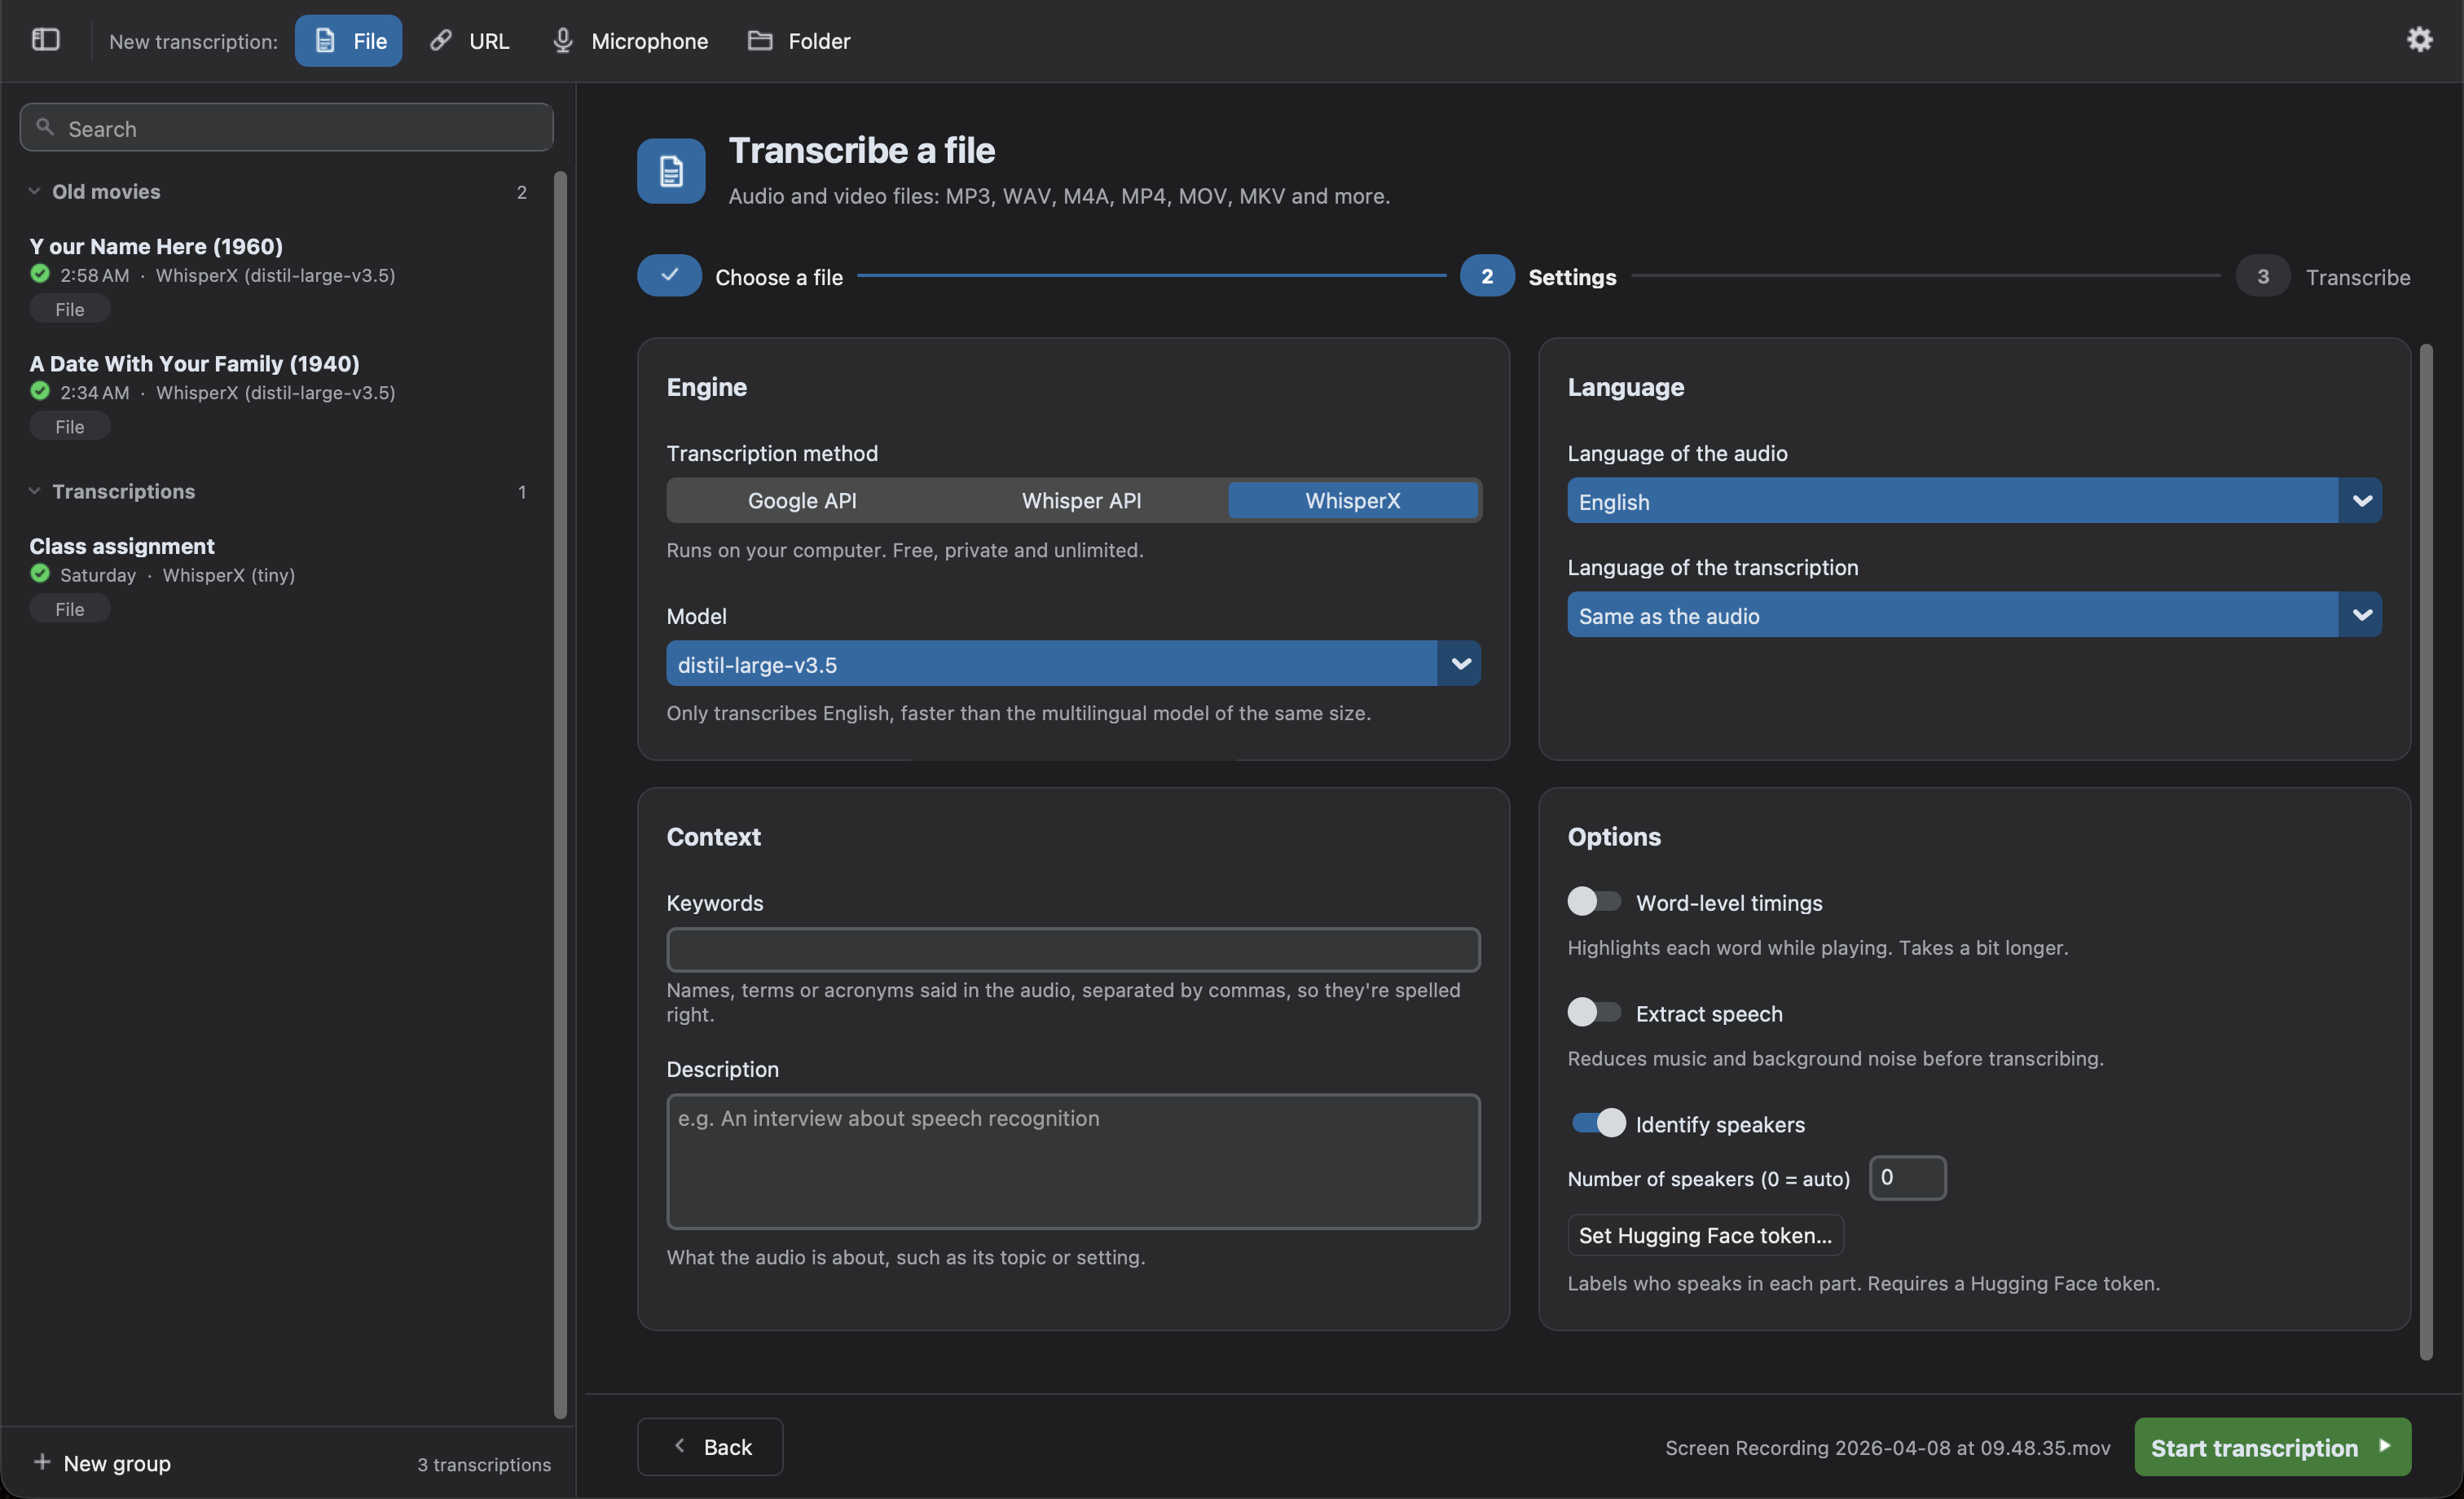
Transkriberingsmetod:
| Motor | Körs på | Kostnad | Kommentarer |
|---|---|---|---|
| WhisperX (standard) | Din dator | Gratis och obegränsat | Privat och offline. Fler alternativ: talare, tider per ord, livetext. Körs på grafikprocessorn i Mac-datorer med Apple Silicon. |
| Whisper-API | OpenAI:s servrar | Betalas per minut | Kräver en API-nyckel från OpenAI. För datorer som inte kör WhisperX smidigt. |
| Google-API | Googles servrar | Gratisnivå eller betald | Lägre kvalitet och inga tidsstämplar. En API-nyckel är valfri. |
Modell beror på motorn. Med WhisperX är större modeller mer exakta men långsammare. Med Whisper-API:t avgör den om transkriberingen har tidsstämplar och talare. Se Motorer för att jämföra dem.
- Ljudets språk: Identifiera automatiskt som standard. Om du väljer det undviker du fel i korta eller blandade inspelningar. Google-API:t kan inte identifiera det, så där måste du välja det.
- Transkriberingens språk: Samma som ljudet som standard. Välj ett annat språk för att översätta ljudet under transkriberingen.
När språken skiljer sig åt visas alternativen under Översättning:
- Översätt med Whisper (rekommenderas): Whisper transkriberar och översätter ljudet i ett steg. Det kan bara översätta till engelska.
- Skriv den direkt på språk (experimentellt): Whisper ombeds skriva transkriberingen direkt på det språket. Det fungerar bra för många språk, men kontrollera resultatet.
Google-API:t kan inte översätta. För att senare översätta en transkribering till valfritt språk, med fler leverantörer, använder du transkriptets knapp Översätt.
Sammanhang
Section titled “Sammanhang”Två valfria fält som hjälper modellen:
- Nyckelord: namn, termer eller förkortningar som sägs i ljudet, separerade med kommatecken (t.ex.
Audiotext, WhisperX, Henestrosa), så att de stavas rätt. De är bara tips: ett nyckelord skrivs bara om det sägs i ljudet. - Beskrivning: vad ljudet handlar om, som ämne eller miljö (t.ex.
En intervju om taligenkänning).
De används av WhisperX och Whisper-API:t, utom av modellen gpt-4o-transcribe-diarize. Google-API:t använder dem inte.
Alternativ
Section titled “Alternativ”- Tider per ord (WhisperX): justerar varje ord mot ljudet för att markera det under uppspelning och för att granska orden som den är minst säker på. Tar lite längre tid. På som standard. Undertexterna behöver ordens tider, så alternativet slås på och låses medan
.srteller.vttär valt under Filtyper för en mapp; ditt eget val kommer tillbaka när de inte längre är valda. - Minska bakgrundsbrus: minskar brum och jämnt bakgrundsbrus, och jämnar ut tyst tal, innan transkriberingen. Tar längre tid.
- Identifiera talare (WhisperX): anger vem som talar i varje del, t.ex.
SPEAKER_00. Om du vet hur många som talar anger du det i Antal talare (0identifierar det automatiskt). Kräver en gratis Hugging Face-token; se Identifiera talarna. Med Whisper-API:t identifierar modellengpt-4o-transcribe-diarizetalarna.
Identifiera talarna
Section titled “Identifiera talarna”Modellen som identifierar talarna, pyannote/speaker-diarization-community-1, är gratis men kräver en Hugging Face-token:
- Skapa ett konto på Hugging Face och godkänn villkoren för pyannote/speaker-diarization-community-1.
- Skapa en token med rollen
Readi dina inställningar. - Klicka på Ange Hugging Face-token… och klistra in den.
Modellen laddas ner första gången den används. Därefter identifieras talarna offline.
Livetext
Section titled “Livetext”Visas bara för mikrofonen. Se Livetext.
Mapp och Utdata
Section titled “Mapp och Utdata”Visas bara för mappar:
- Bevaka mappen: se Bevaka en mapp.
- Transkribera filerna som redan finns i mappen (bara vid bevakning): transkriberar först de filer som redan finns i mappen och som inte har någon transkribering än. Av som standard.
- Inkludera undermappar: transkriberar även filerna i undermapparna.
- Hoppa över filer som matchar: namn eller sökvägar för filerna som ska hoppas över, separerade med kommatecken (t.ex.
*.wav, drafts/*). Dolda filer hoppas alltid över. - Filtyper: med WhisperX en eller flera av
.txt,.srt,.vtt,.json,.tsvoch.aud. Med Whisper-API:t filernas format (text,json,verbose_json,srtellervtt); undertexter kräver en modell med tidsstämplar. Google-API:t returnerar oformaterad text (.txt). - Plats: filerna sparas bredvid varje källfil. Klicka på Ändra… för att spara dem i en annan mapp (dess undermappar återskapas), eller på Bredvid källan för att gå tillbaka.
Filer som redan har en transkribering hoppas över. Använd alternativen för filerna i mappen för att transkribera dem igen.
Undertextalternativen (radbredd, antal rader, markerade ord) finns i Inställningar.