

Paramètres de transcription
Avant de transcrire, Audiotext affiche les paramètres de la transcription, regroupés en cartes. Ils sont mémorisés pour la fois suivante, et chaque transcription conserve les paramètres avec lesquels elle a été faite.
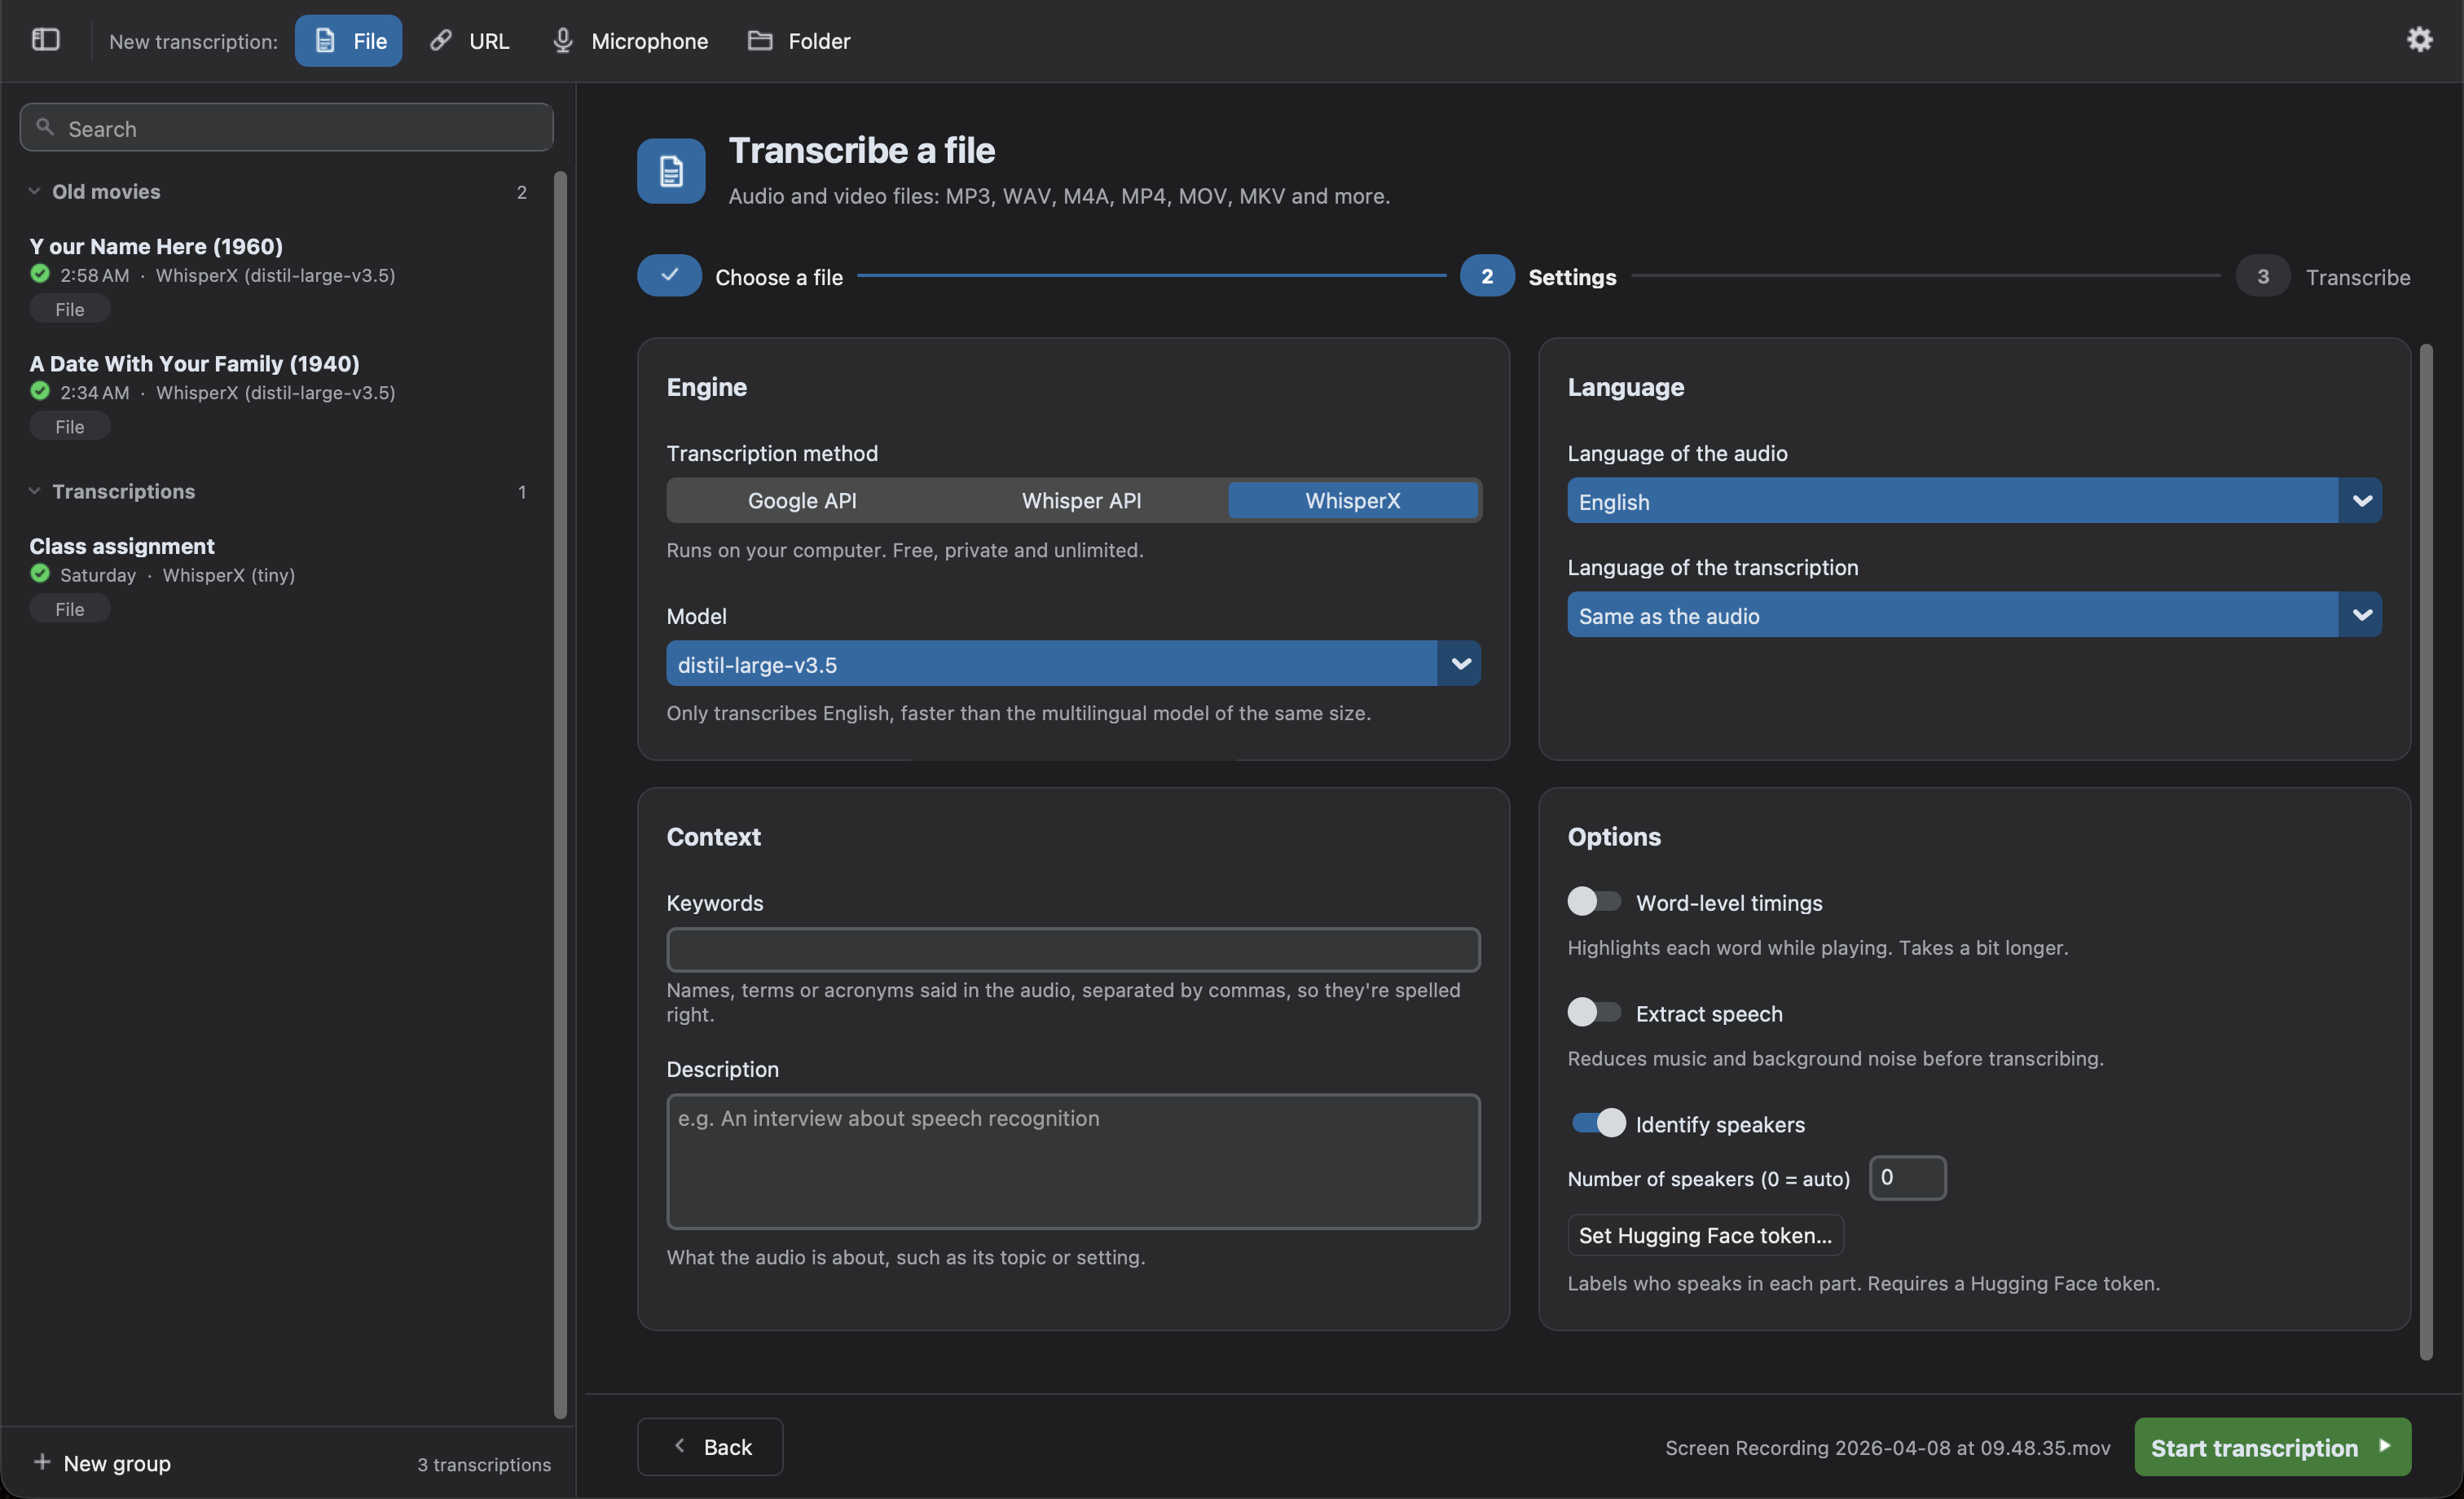
La Méthode de transcription :
| Moteur | Où il s’exécute | Coût | Remarques |
|---|---|---|---|
| WhisperX (par défaut) | Votre ordinateur | Gratuit et illimité | Privé et hors ligne. Plus d’options : locuteurs, minutage par mot, texte en direct. Tourne sur le GPU des Mac avec Apple Silicon. |
| API Whisper | Serveurs d’OpenAI | Payant à la minute | Nécessite une clé API OpenAI. Pour les ordinateurs qui ne peuvent pas faire tourner WhisperX correctement. |
| API Google | Serveurs de Google | Offre gratuite, ou payant | Qualité moindre et sans horodatage. La clé API est facultative. |
Le Modèle dépend du moteur. Avec WhisperX, les modèles plus grands sont plus précis, mais plus lents. Avec l’API Whisper, il détermine si la transcription comporte des horodatages et des locuteurs. Consultez Moteurs pour les comparer.
- Langue de l’audio : Détection automatique par défaut. La choisir évite les erreurs sur les audios courts ou mélangés. L’API Google ne peut pas la détecter, vous devez donc la choisir.
- Langue de la transcription : Identique à l’audio par défaut. Choisissez une autre langue pour traduire l’audio pendant la transcription.
Lorsque les deux langues diffèrent, les options de Traduction apparaissent :
- Traduire avec Whisper (recommandé) : Whisper transcrit et traduit l’audio en une seule étape. Il ne peut traduire que vers l’anglais.
- L’écrire directement en langue (expérimental) : Whisper est invité à écrire directement la transcription dans cette langue. Cela fonctionne bien pour de nombreuses langues, mais vérifiez le résultat.
L’API Google ne peut pas traduire. Pour traduire une transcription dans n’importe quelle langue plus tard, avec davantage de fournisseurs, utilisez le bouton Traduire de la transcription.
Contexte
Section intitulée « Contexte »Deux champs facultatifs qui aident le modèle :
- Mots-clés : les noms, termes ou sigles prononcés dans l’audio, séparés par des virgules (p. ex.
Audiotext, WhisperX, Henestrosa), pour qu’ils soient bien orthographiés. Ce ne sont que des indications : un mot-clé n’est écrit que s’il est prononcé dans l’audio. - Description : le sujet de l’audio, comme son thème ou son cadre (p. ex.
Un entretien sur la reconnaissance vocale).
Ils sont utilisés par WhisperX et l’API Whisper, sauf par le modèle gpt-4o-transcribe-diarize. L’API Google ne les utilise pas.
- Minutage par mot (WhisperX) : aligne chaque mot sur l’audio, pour le surligner pendant la lecture et pour réviser les mots dont il est le moins sûr. Un peu plus long. Activé par défaut. Les sous-titres ont besoin du minutage des mots : l’option est donc activée et verrouillée tant que
.srtou.vttest choisi dans les Types de fichiers d’un dossier ; votre propre choix revient dès qu’ils ne le sont plus. - Réduire le bruit de fond : réduit le ronflement et le bruit de fond constant, et égalise la parole faible, avant la transcription. Prend plus de temps.
- Identifier les locuteurs (WhisperX) : indique qui parle dans chaque partie, p. ex.
SPEAKER_00. Si vous savez combien de personnes parlent, indiquez-le dans Nombre de locuteurs (0le détecte). Nécessite un jeton Hugging Face gratuit ; consultez Identifiez les locuteurs. Avec l’API Whisper, le modèlegpt-4o-transcribe-diarizeidentifie les locuteurs.
Identifiez les locuteurs
Section intitulée « Identifiez les locuteurs »Le modèle qui identifie les locuteurs, pyannote/speaker-diarization-community-1, est gratuit, mais nécessite un jeton Hugging Face :
- Créez un compte sur Hugging Face et acceptez les conditions de pyannote/speaker-diarization-community-1.
- Créez un jeton avec le rôle
Readdans vos paramètres. - Cliquez sur Configurer le jeton Hugging Face… et collez-le.
Le modèle est téléchargé lors de sa première utilisation. Ensuite, les locuteurs sont identifiés hors ligne.
Texte en direct
Section intitulée « Texte en direct »Affiché uniquement pour le microphone. Consultez Texte en direct.
Dossier et Sortie
Section intitulée « Dossier et Sortie »Affichés uniquement pour les dossiers :
- Surveiller le dossier : consultez Surveillez un dossier.
- Transcrire les fichiers déjà présents dans le dossier (uniquement pendant la surveillance) : transcrit d’abord les fichiers que le dossier contient déjà et qui n’ont pas encore de transcription. Désactivé par défaut.
- Inclure les sous-dossiers : transcrit aussi les fichiers des sous-dossiers.
- Ignorer les fichiers correspondant à : noms ou chemins des fichiers à ignorer, séparés par des virgules (par ex.
*.wav, drafts/*). Les fichiers cachés sont toujours ignorés. - Types de fichiers : avec WhisperX, un ou plusieurs parmi
.txt,.srt,.vtt,.json,.tsvet.aud. Avec l’API Whisper, le format des fichiers (text,json,verbose_json,srtouvtt) ; les sous-titres nécessitent un modèle avec horodatage. L’API Google renvoie du texte brut (.txt). - Emplacement : les fichiers sont enregistrés à côté de chaque fichier source. Cliquez sur Modifier… pour les enregistrer dans un autre dossier (ses sous-dossiers sont recréés), ou sur À côté de la source pour revenir.
Les fichiers qui ont déjà une transcription sont ignorés. Pour les transcrire à nouveau, utilisez les options des fichiers du dossier.
Les options des sous-titres (largeur de ligne, nombre de lignes, mots surlignés) se trouvent dans les Préférences.