

Transcriptie-instellingen
Voor het transcriberen toont Audiotext de instellingen van de transcriptie, gegroepeerd in kaarten. Ze worden onthouden voor de volgende keer, en elke transcriptie bewaart de instellingen waarmee hij is gemaakt.
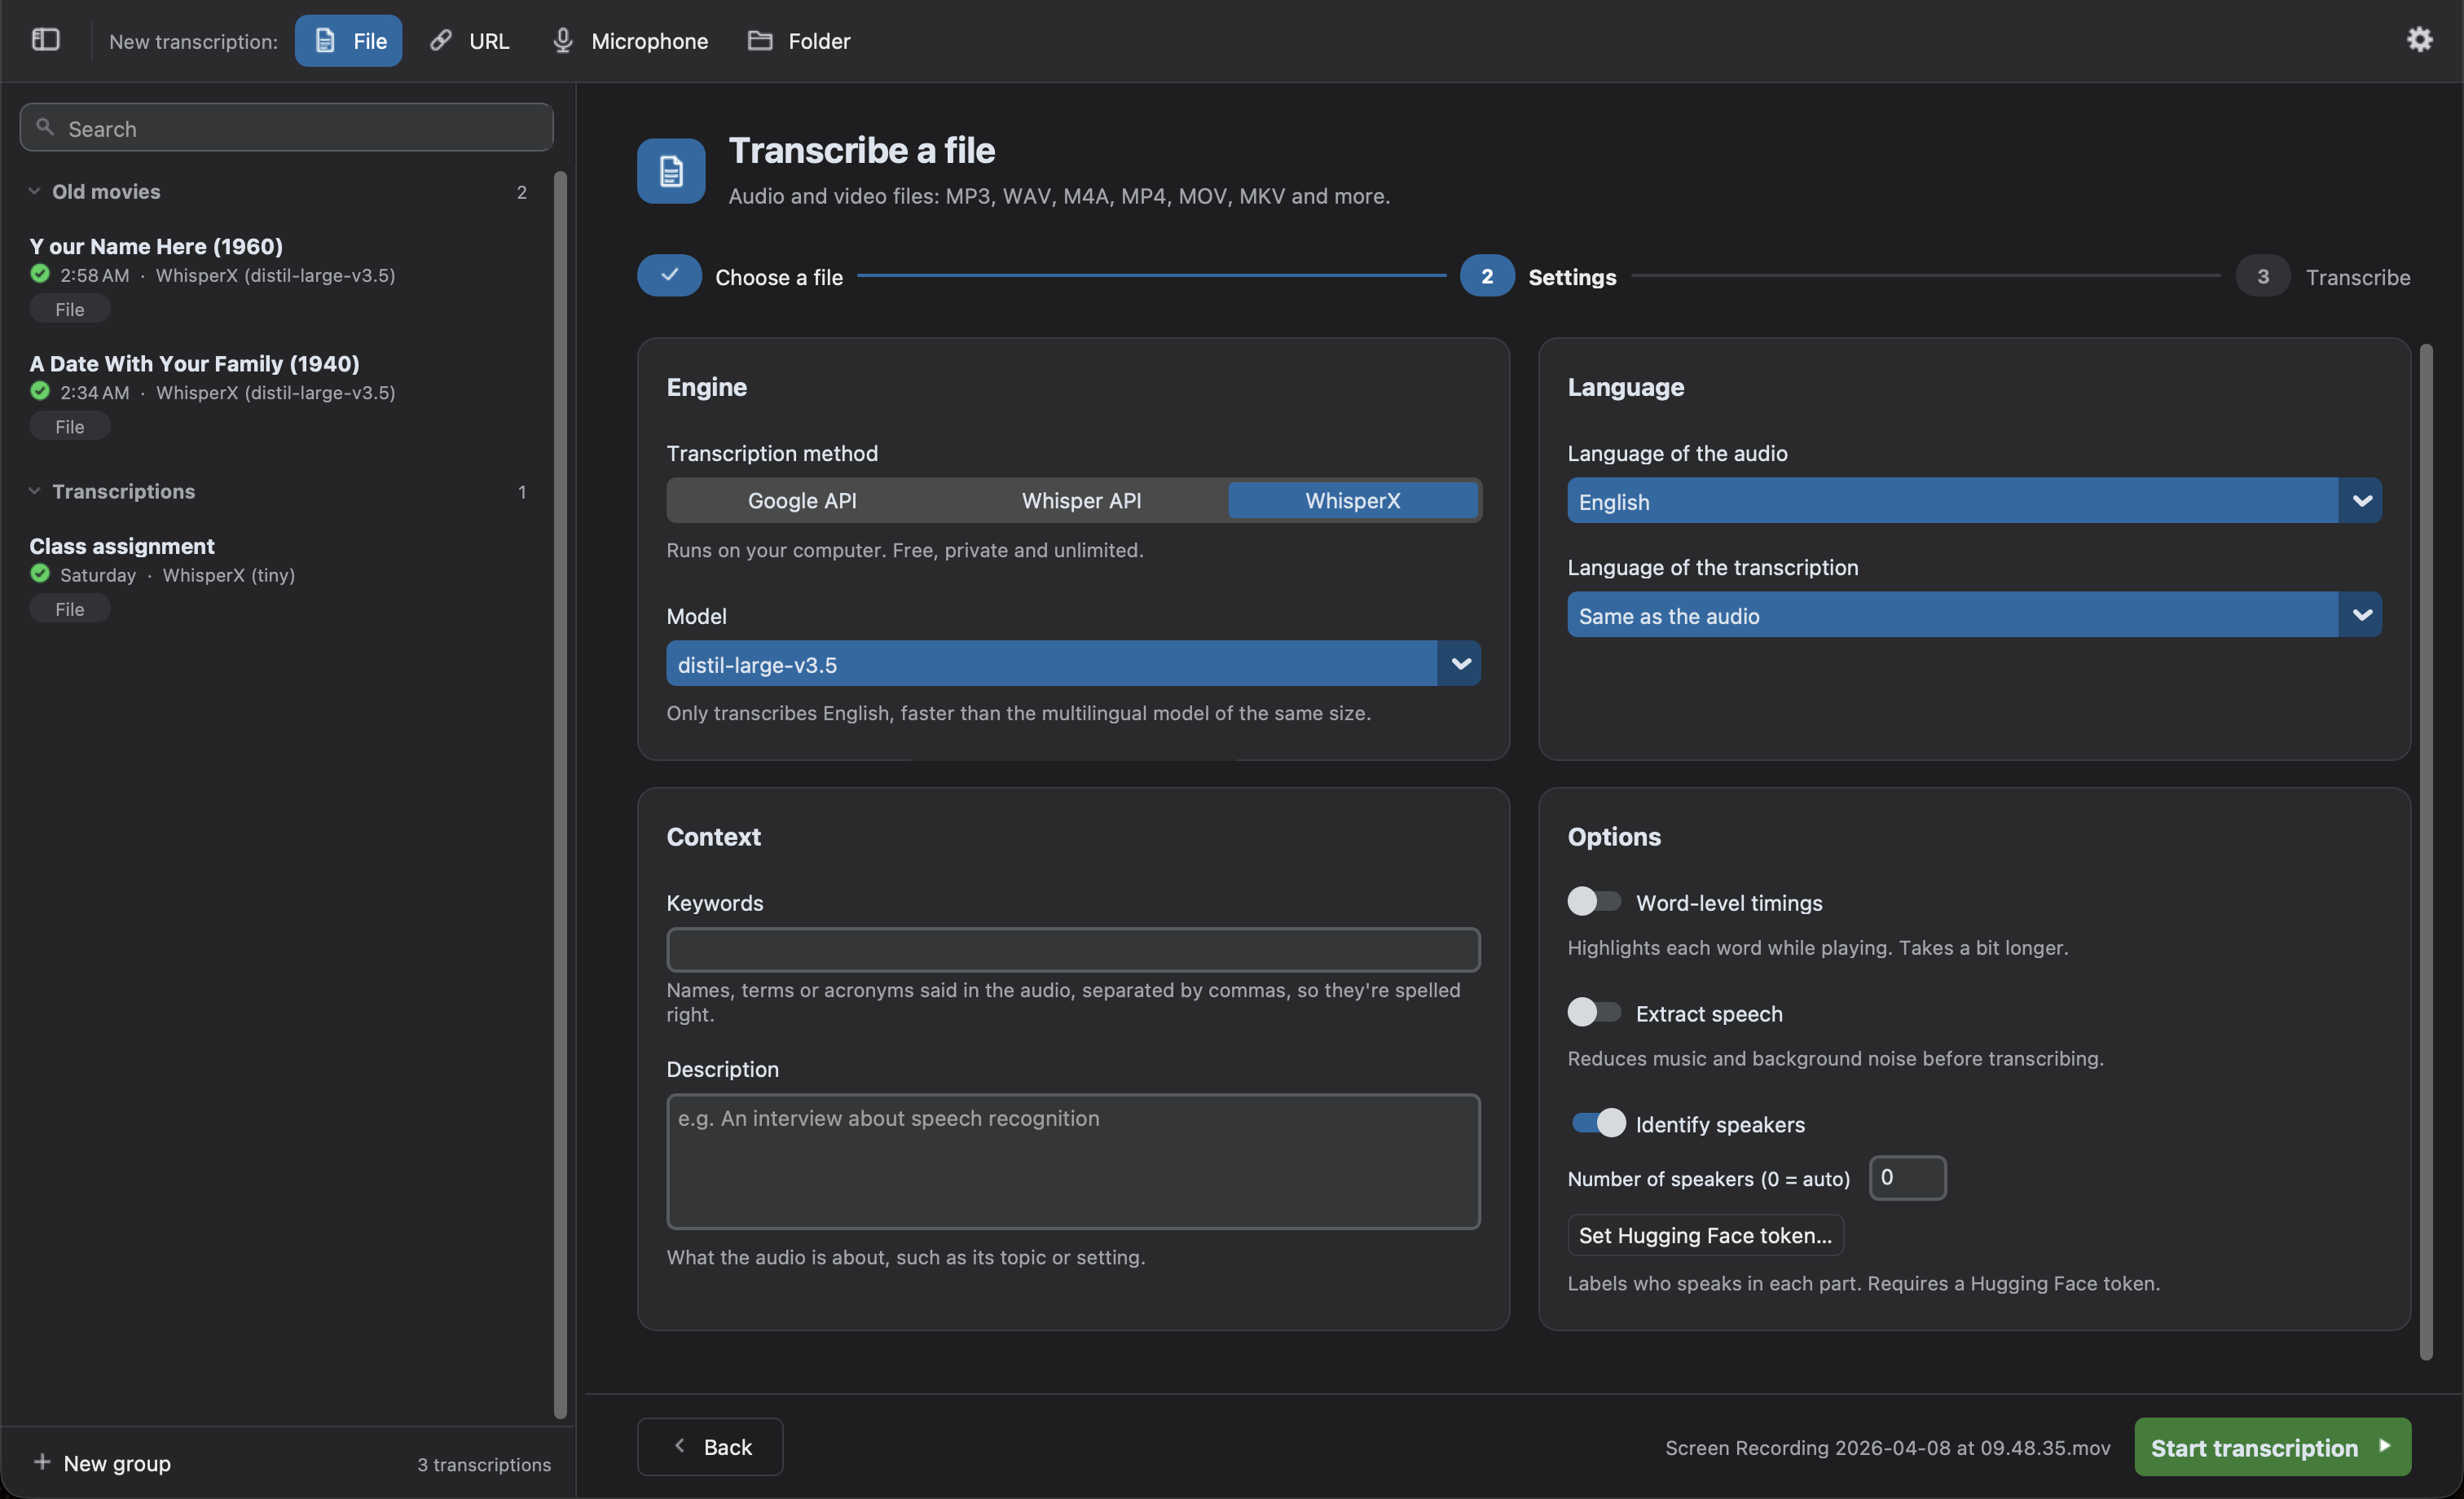
Engine
Section titled “Engine”De Transcriptiemethode:
| Engine | Draait op | Kosten | Opmerkingen |
|---|---|---|---|
| WhisperX (standaard) | Je computer | Gratis en onbeperkt | Privé en offline. Meer opties: sprekers, tijden per woord, livetekst. Draait op de GPU van Macs met Apple Silicon. |
| Whisper-API | Servers van OpenAI | Betaald per minuut | Vereist een OpenAI-API-sleutel. Voor computers waarop WhisperX niet soepel draait. |
| Google-API | Servers van Google | Gratis tegoed, of betaald | Lagere kwaliteit en geen tijdstempels. Een API-sleutel is optioneel. |
Het Model hangt af van de engine. Bij WhisperX zijn grotere modellen nauwkeuriger, maar trager. Bij de Whisper-API bepaalt het of de transcriptie tijdstempels en sprekers heeft. Zie Engines om ze te vergelijken.
- Taal van de audio: standaard Automatisch detecteren. Door hem te kiezen voorkom je fouten bij korte of gemengde audio. De Google-API kan hem niet detecteren, dus daar moet je hem kiezen.
- Taal van de transcriptie: standaard Zelfde als de audio. Kies een andere taal om de audio tijdens het transcriberen te vertalen.
Als beide talen verschillen, verschijnen de opties onder Vertaling:
- Vertalen met Whisper (aanbevolen): Whisper transcribeert en vertaalt de audio in één stap. Het kan alleen naar het Engels vertalen.
- Rechtstreeks in het taal schrijven (experimenteel): Whisper wordt gevraagd de transcriptie direct in die taal te schrijven. Dat werkt voor veel talen goed, maar controleer het resultaat.
De Google-API kan niet vertalen. Gebruik de knop Vertalen van het transcript om een transcriptie later met meer aanbieders naar elke taal te vertalen.
Context
Section titled “Context”Twee optionele velden die het model helpen:
- Trefwoorden: namen, termen of afkortingen die in de audio worden gezegd, gescheiden door komma’s (bijv.
Audiotext, WhisperX, Henestrosa), zodat ze goed gespeld worden. Het zijn alleen hints: een trefwoord wordt alleen geschreven als het in de audio gezegd wordt. - Beschrijving: waar de audio over gaat, zoals het onderwerp of de setting (bijv.
Een interview over spraakherkenning).
Ze worden gebruikt door WhisperX en de Whisper-API, behalve door het model gpt-4o-transcribe-diarize. De Google-API gebruikt ze niet.
Opties
Section titled “Opties”- Tijden per woord (WhisperX): lijnt elk woord uit met de audio, om het tijdens het afspelen te markeren en om de woorden na te kijken waarvan het het minst zeker is. Duurt iets langer. Standaard aan. De ondertitels hebben de tijden van de woorden nodig, dus de optie wordt aangezet en vergrendeld zolang
.srtof.vttis gekozen bij de Bestandstypen van een map; je eigen keuze komt terug zodra ze niet meer gekozen zijn. - Achtergrondruis verminderen: vermindert brom en constante achtergrondruis, en maakt zachte spraak gelijkmatiger, voordat er wordt getranscribeerd. Duurt langer.
- Sprekers herkennen (WhisperX): geeft aan wie in elk deel spreekt, bijv.
SPEAKER_00. Als je weet hoeveel mensen er spreken, vul het in bij Aantal sprekers (0detecteert het). Vereist een gratis Hugging Face-token; zie Sprekers herkennen. Bij de Whisper-API herkent het modelgpt-4o-transcribe-diarizede sprekers.
Sprekers herkennen
Section titled “Sprekers herkennen”Het model dat de sprekers herkent, pyannote/speaker-diarization-community-1, is gratis, maar vereist een Hugging Face-token:
- Maak een account aan op Hugging Face en accepteer de voorwaarden van pyannote/speaker-diarization-community-1.
- Maak een token met de rol
Readaan in je instellingen. - Klik op Hugging Face-token instellen… en plak het.
Het model wordt bij het eerste gebruik gedownload. Daarna worden de sprekers offline herkend.
Livetekst
Section titled “Livetekst”Alleen getoond voor de microfoon. Zie Livetekst.
Map en Uitvoer
Section titled “Map en Uitvoer”Alleen getoond voor mappen:
- Map bewaken: zie Een map bewaken.
- Bestanden transcriberen die al in de map staan (alleen tijdens het bewaken): transcribeert eerst de bestanden die al in de map staan en nog geen transcriptie hebben. Standaard uit.
- Submappen opnemen: transcribeert ook de bestanden van de submappen.
- Bestanden overslaan die overeenkomen met: namen of paden van de bestanden die worden overgeslagen, gescheiden door komma’s (bijv.
*.wav, drafts/*). Verborgen bestanden worden altijd overgeslagen. - Bestandstypen: bij WhisperX een of meer van
.txt,.srt,.vtt,.json,.tsven.aud. Bij de Whisper-API het formaat van de bestanden (text,json,verbose_json,srtofvtt); ondertitels vereisen een model met tijdstempels. De Google-API levert platte tekst (.txt). - Locatie: de bestanden worden naast elk bronbestand opgeslagen. Klik op Wijzigen… om ze in een andere map op te slaan (de submappen worden nagemaakt), of op Naast de bron om terug te gaan.
Bestanden die al een transcriptie hebben, worden overgeslagen. Gebruik de opties van de bestanden van de map om ze opnieuw te transcriberen.
De opties voor ondertitels (regelbreedte, aantal regels, gemarkeerde woorden) staan in de Voorkeuren.