

Transkriptionseinstellungen
Vor dem Transkribieren zeigt Audiotext die Einstellungen der Transkription, gruppiert in Karten. Sie werden für das nächste Mal gespeichert, und jede Transkription behält die Einstellungen, mit denen sie erstellt wurde.
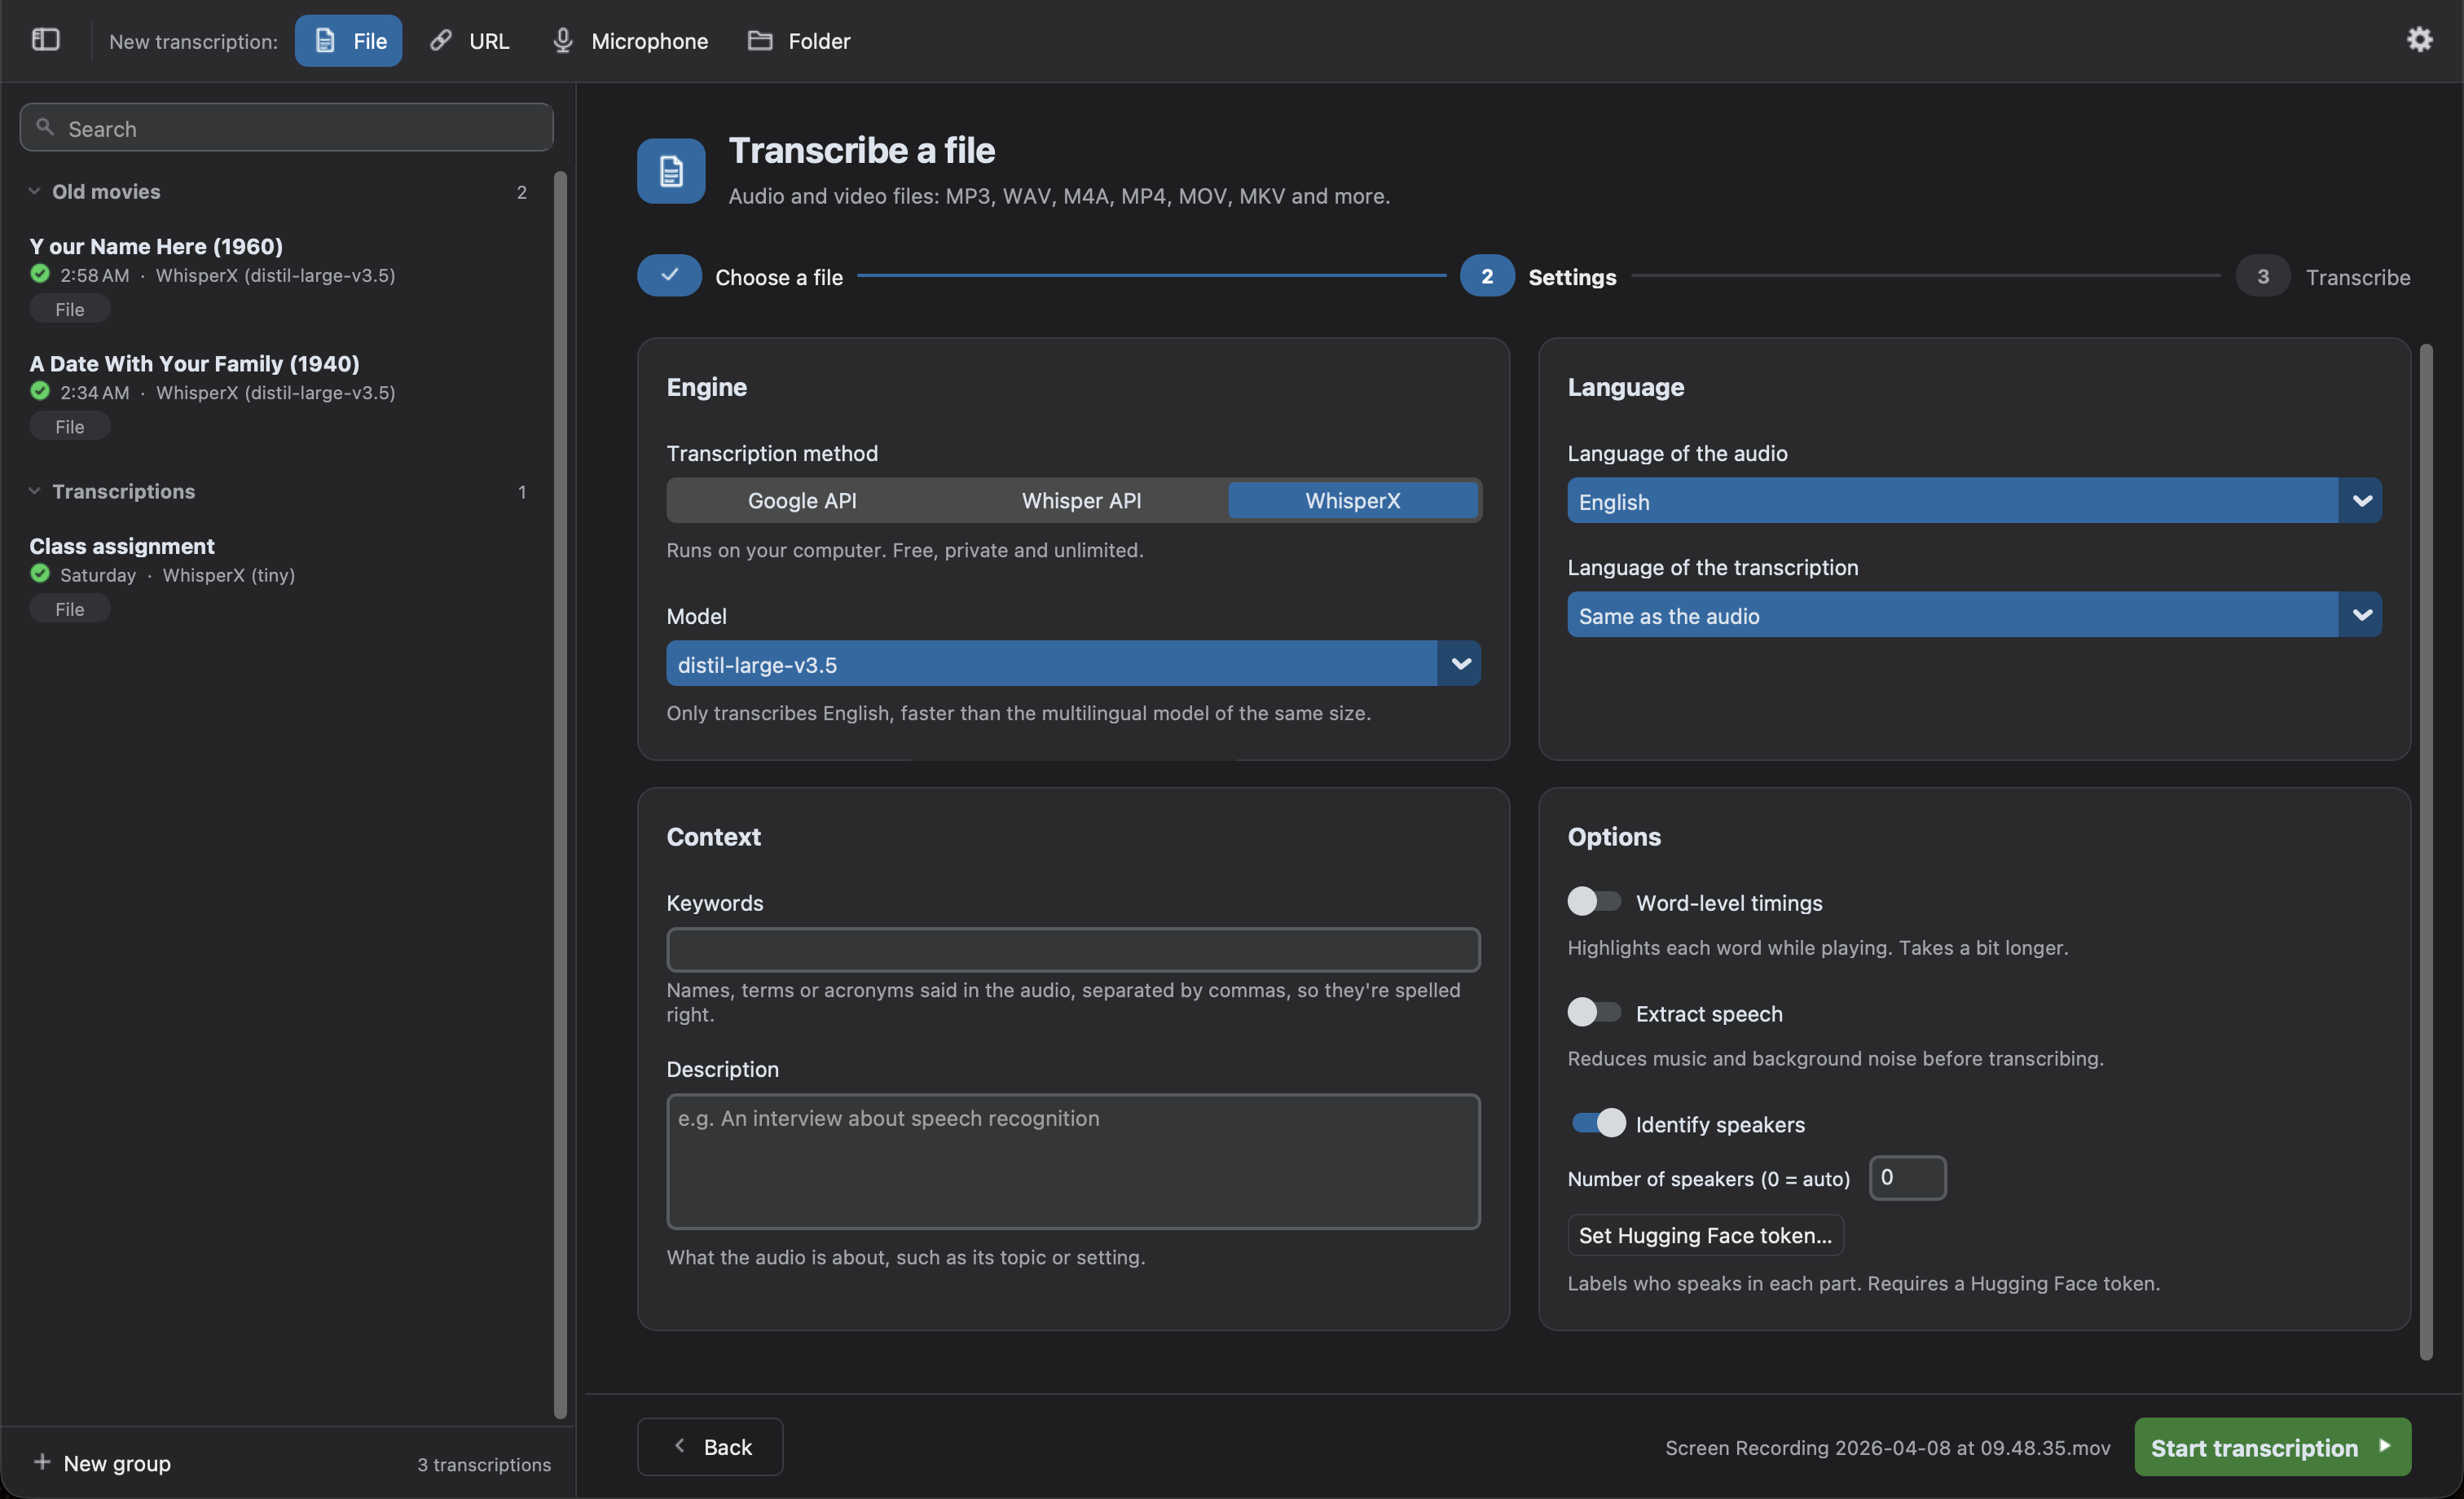
Die Transkriptionsmethode:
| Engine | Läuft auf | Kosten | Hinweise |
|---|---|---|---|
| WhisperX (Standard) | Ihrem Computer | Kostenlos und unbegrenzt | Privat und offline. Mehr Optionen: Sprecher, Zeiten pro Wort, Live-Text. Läuft auf der GPU von Macs mit Apple Silicon. |
| Whisper-API | Servern von OpenAI | Kostenpflichtig pro Minute | Erfordert einen OpenAI-API-Schlüssel. Für Computer, auf denen WhisperX nicht flüssig läuft. |
| Google-API | Servern von Google | Kostenloses Kontingent oder kostenpflichtig | Geringere Qualität und keine Zeitstempel. Ein API-Schlüssel ist optional. |
Das Modell hängt von der Engine ab. Bei WhisperX sind größere Modelle genauer, aber langsamer. Bei der Whisper-API bestimmt es, ob die Transkription Zeitstempel und Sprecher hat. Vergleichen Sie sie unter Engines.
Sprache
Abschnitt betitelt „Sprache“- Sprache des Audios: standardmäßig Automatisch erkennen. Wenn Sie sie auswählen, vermeiden Sie Fehler bei kurzen oder gemischten Aufnahmen. Die Google-API kann sie nicht erkennen, daher müssen Sie sie auswählen.
- Sprache der Transkription: standardmäßig Wie das Audio. Wählen Sie eine andere Sprache, um das Audio beim Transkribieren zu übersetzen.
Wenn sich beide Sprachen unterscheiden, erscheinen die Optionen unter Übersetzung:
- Mit Whisper übersetzen (empfohlen): Whisper transkribiert und übersetzt das Audio in einem Schritt. Es kann nur ins Englische übersetzen.
- Direkt auf Sprache schreiben (experimentell): Whisper wird gebeten, die Transkription direkt in dieser Sprache zu schreiben. Das funktioniert für viele Sprachen gut, prüfen Sie aber das Ergebnis.
Die Google-API kann nicht übersetzen. Um eine Transkription später mit weiteren Anbietern in eine beliebige Sprache zu übersetzen, verwenden Sie die Schaltfläche Übersetzen des Transkripts.
Kontext
Abschnitt betitelt „Kontext“Zwei optionale Felder, die dem Modell helfen:
- Schlüsselwörter: Namen, Begriffe oder Abkürzungen, die im Audio vorkommen, durch Kommas getrennt (z. B.
Audiotext, WhisperX, Henestrosa), damit sie richtig geschrieben werden. Es sind nur Hinweise: Ein Schlüsselwort wird nur geschrieben, wenn es im Audio gesagt wird. - Beschreibung: worum es im Audio geht, etwa das Thema oder der Rahmen (z. B.
Ein Interview über Spracherkennung).
Sie werden von WhisperX und der Whisper-API verwendet, außer vom Modell gpt-4o-transcribe-diarize. Die Google-API verwendet sie nicht.
Optionen
Abschnitt betitelt „Optionen“- Zeiten pro Wort (WhisperX): richtet jedes Wort am Audio aus, um es beim Abspielen hervorzuheben und um die Wörter zu prüfen, bei denen es am wenigsten sicher ist. Dauert etwas länger. Standardmäßig aktiv. Die Untertitel brauchen die Zeiten der Wörter, daher wird die Option eingeschaltet und gesperrt, solange
.srtoder.vttin den Dateitypen eines Ordners gewählt ist; Ihre eigene Wahl kehrt zurück, sobald sie nicht mehr gewählt sind. - Hintergrundgeräusche reduzieren: reduziert Brummen und gleichmäßige Hintergrundgeräusche und gleicht leise Sprache an, bevor transkribiert wird. Dauert länger.
- Sprecher erkennen (WhisperX): kennzeichnet, wer in welchem Teil spricht, z. B.
SPEAKER_00. Wenn Sie wissen, wie viele Personen sprechen, geben Sie es unter Anzahl der Sprecher an (0erkennt sie automatisch). Erfordert ein kostenloses Hugging-Face-Token; siehe Sprecher erkennen. Bei der Whisper-API erkennt das Modellgpt-4o-transcribe-diarizedie Sprecher.
Sprecher erkennen
Abschnitt betitelt „Sprecher erkennen“Das Modell, das die Sprecher erkennt, pyannote/speaker-diarization-community-1, ist kostenlos, erfordert aber ein Hugging-Face-Token:
- Erstellen Sie ein Konto bei Hugging Face und akzeptieren Sie die Bedingungen von pyannote/speaker-diarization-community-1.
- Erstellen Sie in Ihren Einstellungen ein Token mit der Rolle
Read. - Klicken Sie auf Hugging-Face-Token festlegen… und fügen Sie es ein.
Das Modell wird bei der ersten Verwendung heruntergeladen. Danach werden die Sprecher offline erkannt.
Live-Text
Abschnitt betitelt „Live-Text“Wird nur für das Mikrofon angezeigt. Siehe Live-Text.
Ordner und Ausgabe
Abschnitt betitelt „Ordner und Ausgabe“Werden nur für Ordner angezeigt:
- Ordner überwachen: siehe Einen Ordner überwachen.
- Bereits im Ordner vorhandene Dateien transkribieren (nur beim Überwachen): transkribiert zuerst die Dateien, die der Ordner bereits enthält und die noch keine Transkription haben. Standardmäßig deaktiviert.
- Unterordner einbeziehen: transkribiert auch die Dateien der Unterordner.
- Dateien überspringen, die passen auf: Namen oder Pfade der zu überspringenden Dateien, durch Kommas getrennt (z. B.
*.wav, drafts/*). Versteckte Dateien werden immer übersprungen. - Dateitypen: bei WhisperX einer oder mehrere von
.txt,.srt,.vtt,.json,.tsvund.aud. Bei der Whisper-API das Format der Dateien (text,json,verbose_json,srtodervtt); Untertitel erfordern ein Modell mit Zeitstempeln. Die Google-API liefert Nur-Text (.txt). - Speicherort: Die Dateien werden neben jeder Quelldatei gespeichert. Klicken Sie auf Ändern…, um sie in einem anderen Ordner zu speichern (seine Unterordner werden nachgebildet), oder auf Neben der Quelle, um zurückzuwechseln.
Dateien, die bereits eine Transkription haben, werden übersprungen. Um sie erneut zu transkribieren, nutzen Sie die Optionen der Dateien des Ordners.
Die Untertiteloptionen (Zeilenbreite, Zeilenanzahl, hervorgehobene Wörter) finden Sie in den Einstellungen.