

Ajustes de la transcripción
Antes de transcribir, Audiotext muestra los ajustes de la transcripción, agrupados en tarjetas. Se recuerdan para la próxima vez, y cada transcripción guarda los ajustes con los que se hizo.
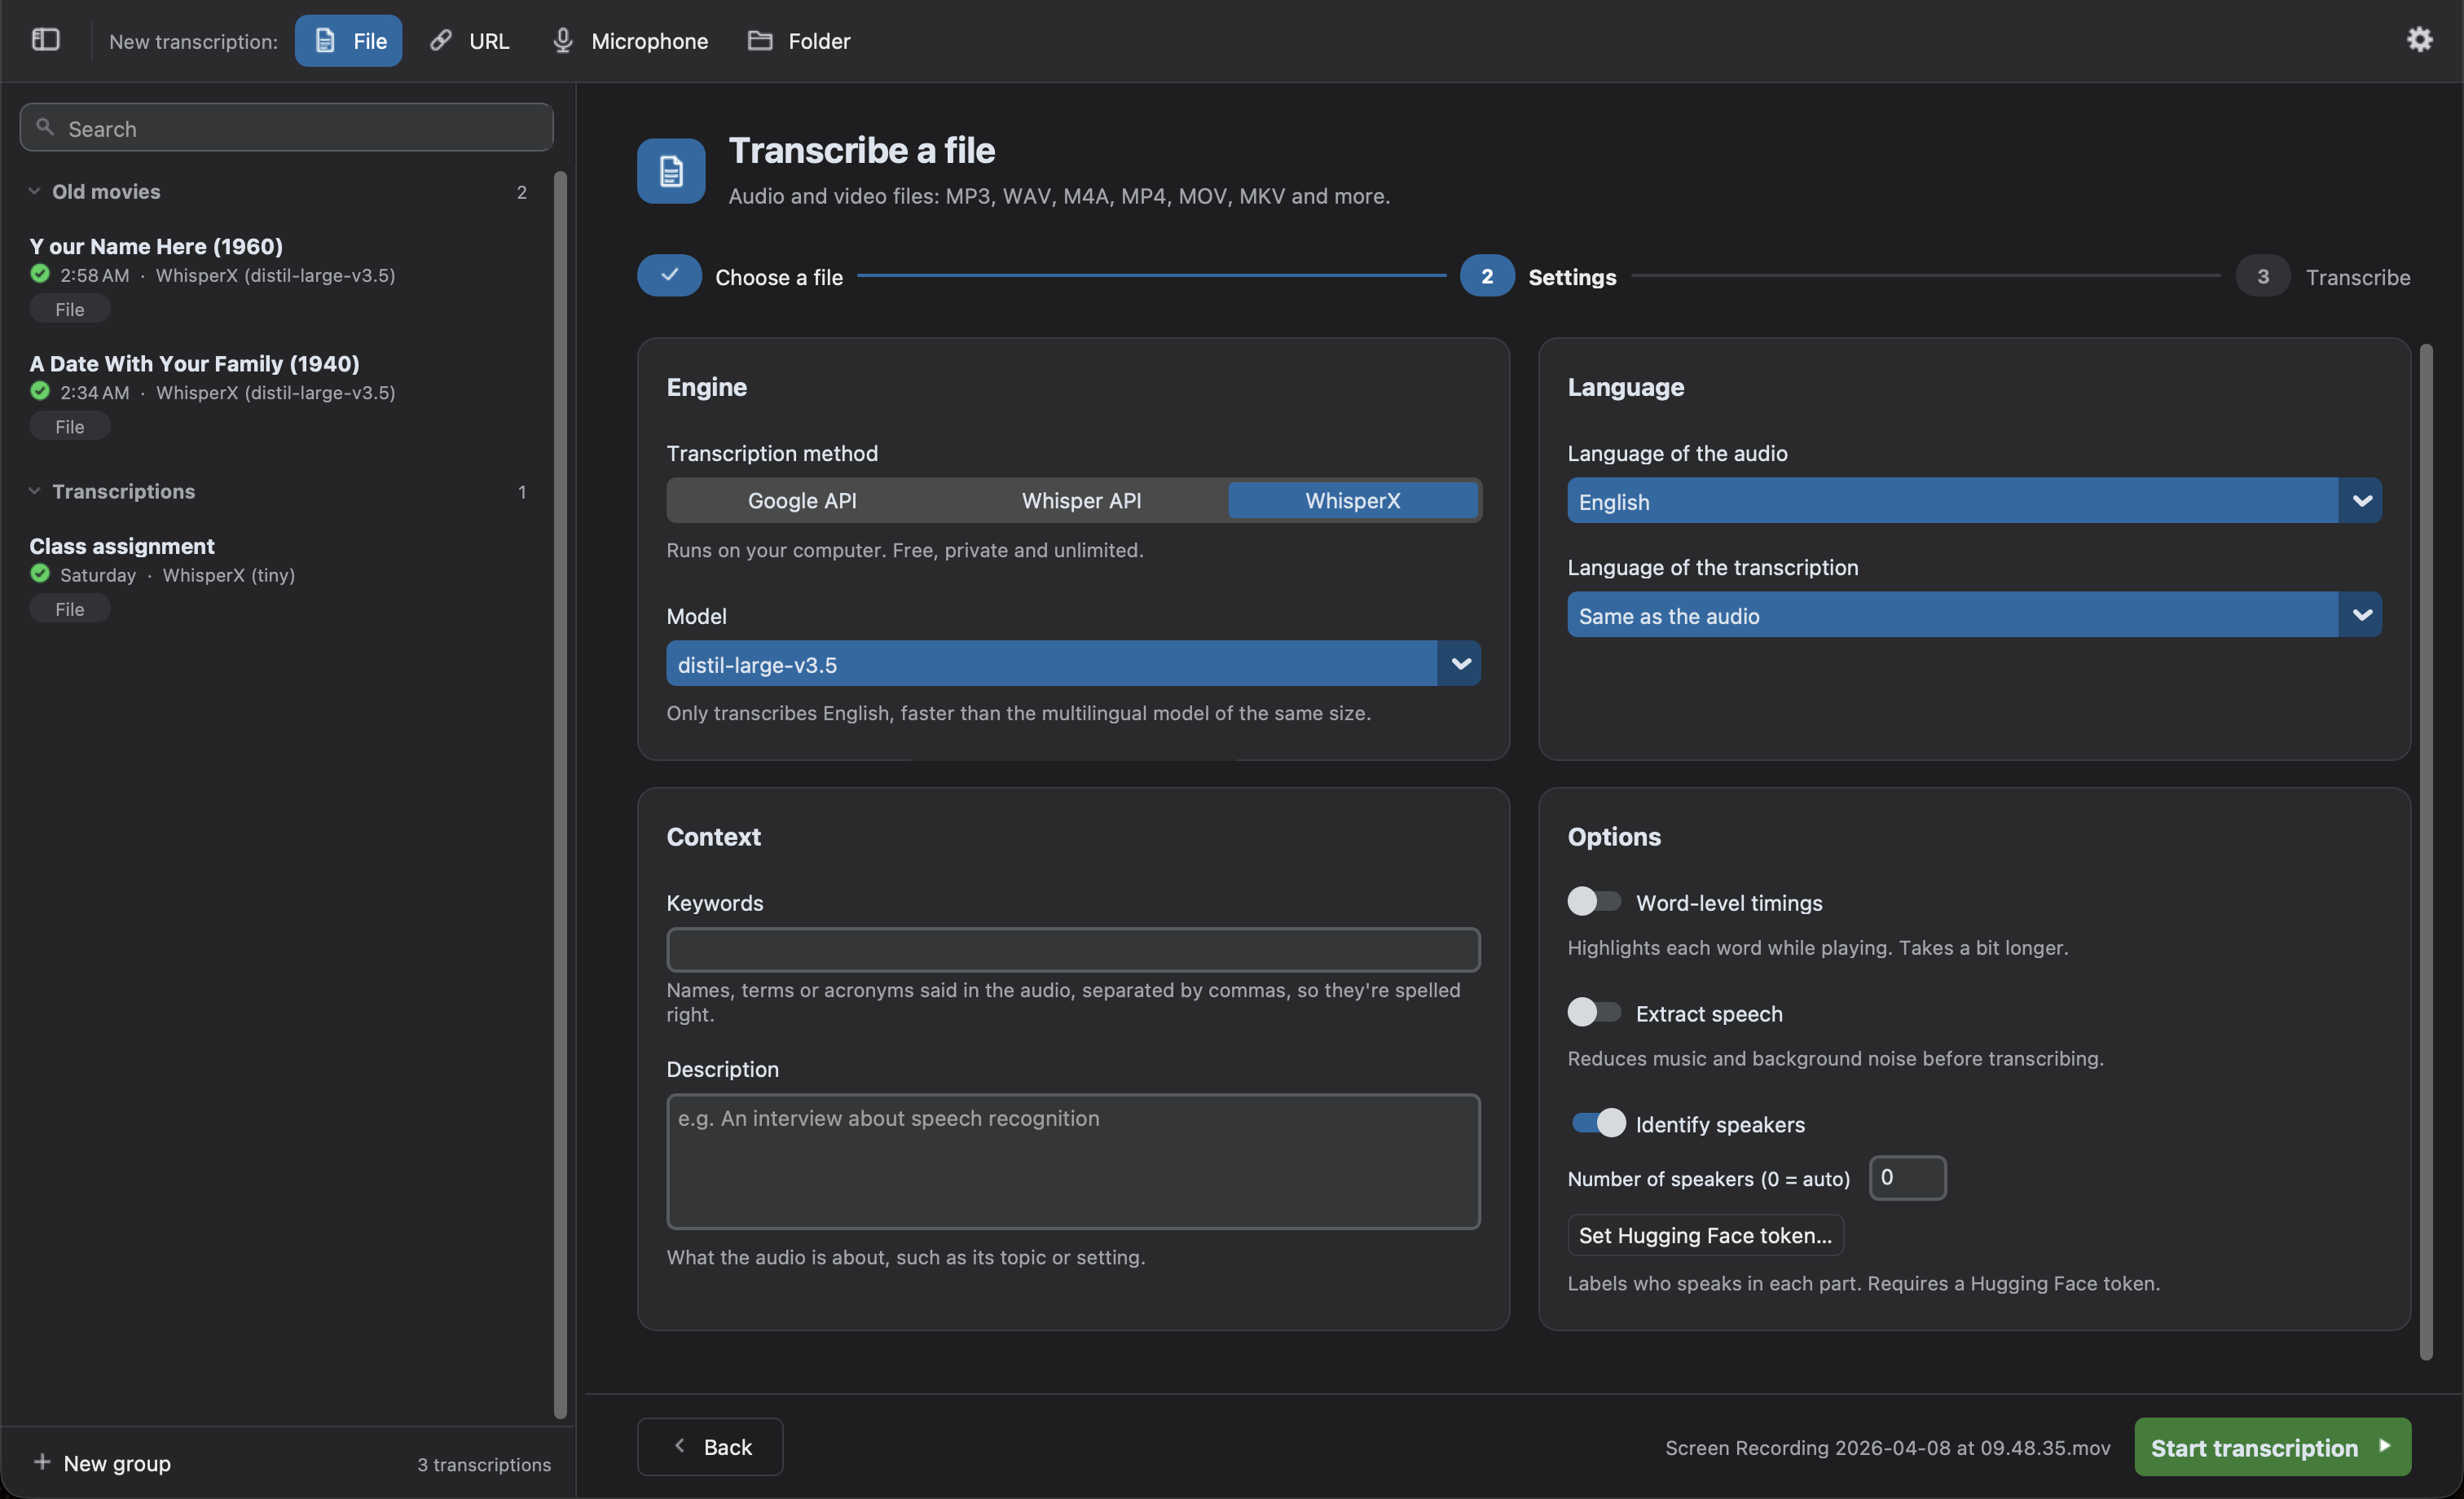
El Método de transcripción:
| Motor | Dónde se ejecuta | Coste | Notas |
|---|---|---|---|
| WhisperX (por defecto) | Tu ordenador | Gratis y sin límites | Privado y sin conexión. Más opciones: hablantes, tiempos por palabra, texto en directo. Funciona en la GPU de los Mac con Apple Silicon. |
| API de Whisper | Servidores de OpenAI | De pago por minuto | Requiere una clave de API de OpenAI. Para ordenadores que no pueden ejecutar WhisperX con fluidez. |
| API de Google | Servidores de Google | Gratuita limitada, o de pago | Menor calidad y sin marcas de tiempo. La clave de API es opcional. |
El Modelo depende del motor. Con WhisperX, los modelos más grandes son más precisos, pero más lentos. Con la API de Whisper, decide si la transcripción tiene marcas de tiempo y hablantes. Consulta Motores para compararlos.
- Idioma del audio: Detectar automáticamente por defecto. Elegirlo evita errores en audios cortos o mezclados. La API de Google no puede detectarlo, así que tienes que elegirlo.
- Idioma de la transcripción: El mismo que el audio por defecto. Elige otro idioma para traducir el audio mientras se transcribe.
Cuando los dos idiomas son distintos, aparecen las opciones de Traducción:
- Traducir con Whisper (recomendado): Whisper transcribe y traduce el audio en un solo paso. Solo puede traducir al inglés.
- Escribirla directamente en idioma (experimental): se le pide a Whisper que escriba la transcripción directamente en ese idioma. Funciona bien en muchos idiomas, pero revisa el resultado.
La API de Google no puede traducir. Para traducir una transcripción a cualquier idioma más tarde, con más proveedores, usa el botón Traducir de la transcripción.
Contexto
Sección titulada «Contexto»Dos campos opcionales que ayudan al modelo:
- Palabras clave: nombres, términos o siglas que se dicen en el audio, separados por comas (p. ej.
Audiotext, WhisperX, Henestrosa), para que se escriban bien. Son solo pistas: una palabra clave solo se escribe si se dice en el audio. - Descripción: de qué trata el audio, como su tema o su contexto (p. ej.
Una entrevista sobre reconocimiento de voz).
Los usan WhisperX y la API de Whisper, salvo el modelo gpt-4o-transcribe-diarize. La API de Google no los usa.
Opciones
Sección titulada «Opciones»- Tiempos por palabra (WhisperX): alinea cada palabra con el audio, para resaltarla al reproducir y para revisar las palabras de las que está menos seguro. Tarda un poco más. Activado por defecto. Los subtítulos necesitan los tiempos de las palabras, así que se activa y se bloquea mientras
.srto.vttestán elegidos en los Tipos de archivo de una carpeta; tu elección vuelve cuando dejan de estarlo. - Reducir el ruido de fondo: reduce el zumbido y el ruido de fondo constante, e iguala la voz baja, antes de transcribir. Tarda más.
- Identificar hablantes (WhisperX): indica quién habla en cada parte, p. ej.
SPEAKER_00. Si sabes cuántas personas hablan, indícalo en Número de hablantes (0lo detecta). Requiere un token gratuito de Hugging Face; consulta Identifica a los hablantes. Con la API de Whisper, el modelogpt-4o-transcribe-diarizeidentifica a los hablantes.
Identifica a los hablantes
Sección titulada «Identifica a los hablantes»El modelo que identifica a los hablantes, pyannote/speaker-diarization-community-1, es gratuito, pero requiere un token de Hugging Face:
- Crea una cuenta en Hugging Face y acepta las condiciones de pyannote/speaker-diarization-community-1.
- Crea un token con el rol
Readen tus ajustes. - Haz clic en Configurar token de Hugging Face… y pégalo.
El modelo se descarga la primera vez que se usa. Después, los hablantes se identifican sin conexión.
Texto en directo
Sección titulada «Texto en directo»Solo se muestra para el micrófono. Consulta Texto en directo.
Carpeta y Salida
Sección titulada «Carpeta y Salida»Solo se muestran para carpetas:
- Vigilar la carpeta: consulta Vigila una carpeta.
- Transcribir los archivos que ya hay en la carpeta (solo al vigilar): primero transcribe los archivos que ya contiene la carpeta y que aún no tienen transcripción. Desactivado por defecto.
- Incluir subcarpetas: también transcribe los archivos de las subcarpetas.
- Omitir los archivos que coincidan con: nombres o rutas de los archivos que se omiten, separados por comas (p. ej.
*.wav, drafts/*). Los archivos ocultos siempre se omiten. - Tipos de archivo: con WhisperX, uno o varios de
.txt,.srt,.vtt,.json,.tsvy.aud. Con la API de Whisper, el formato de los archivos (text,json,verbose_json,srtovtt); los subtítulos necesitan un modelo con marcas de tiempo. La API de Google devuelve texto plano (.txt). - Ubicación: los archivos se guardan junto a cada archivo de origen. Haz clic en Cambiar… para guardarlos en otra carpeta (se recrean sus subcarpetas), o en Junto al origen para volver.
Los archivos que ya tienen una transcripción se omiten. Para volver a transcribirlos, usa las opciones de los archivos de la carpeta.
Las opciones de los subtítulos (ancho de línea, número de líneas, palabras resaltadas) están en las Preferencias.