

받아쓰기 설정
받아쓰기 전에 Audiotext는 설정을 카드로 묶어 보여 줍니다. 설정은 다음을 위해 기억되며, 각 받아쓰기에는 만들 때 쓴 설정이 저장됩니다.
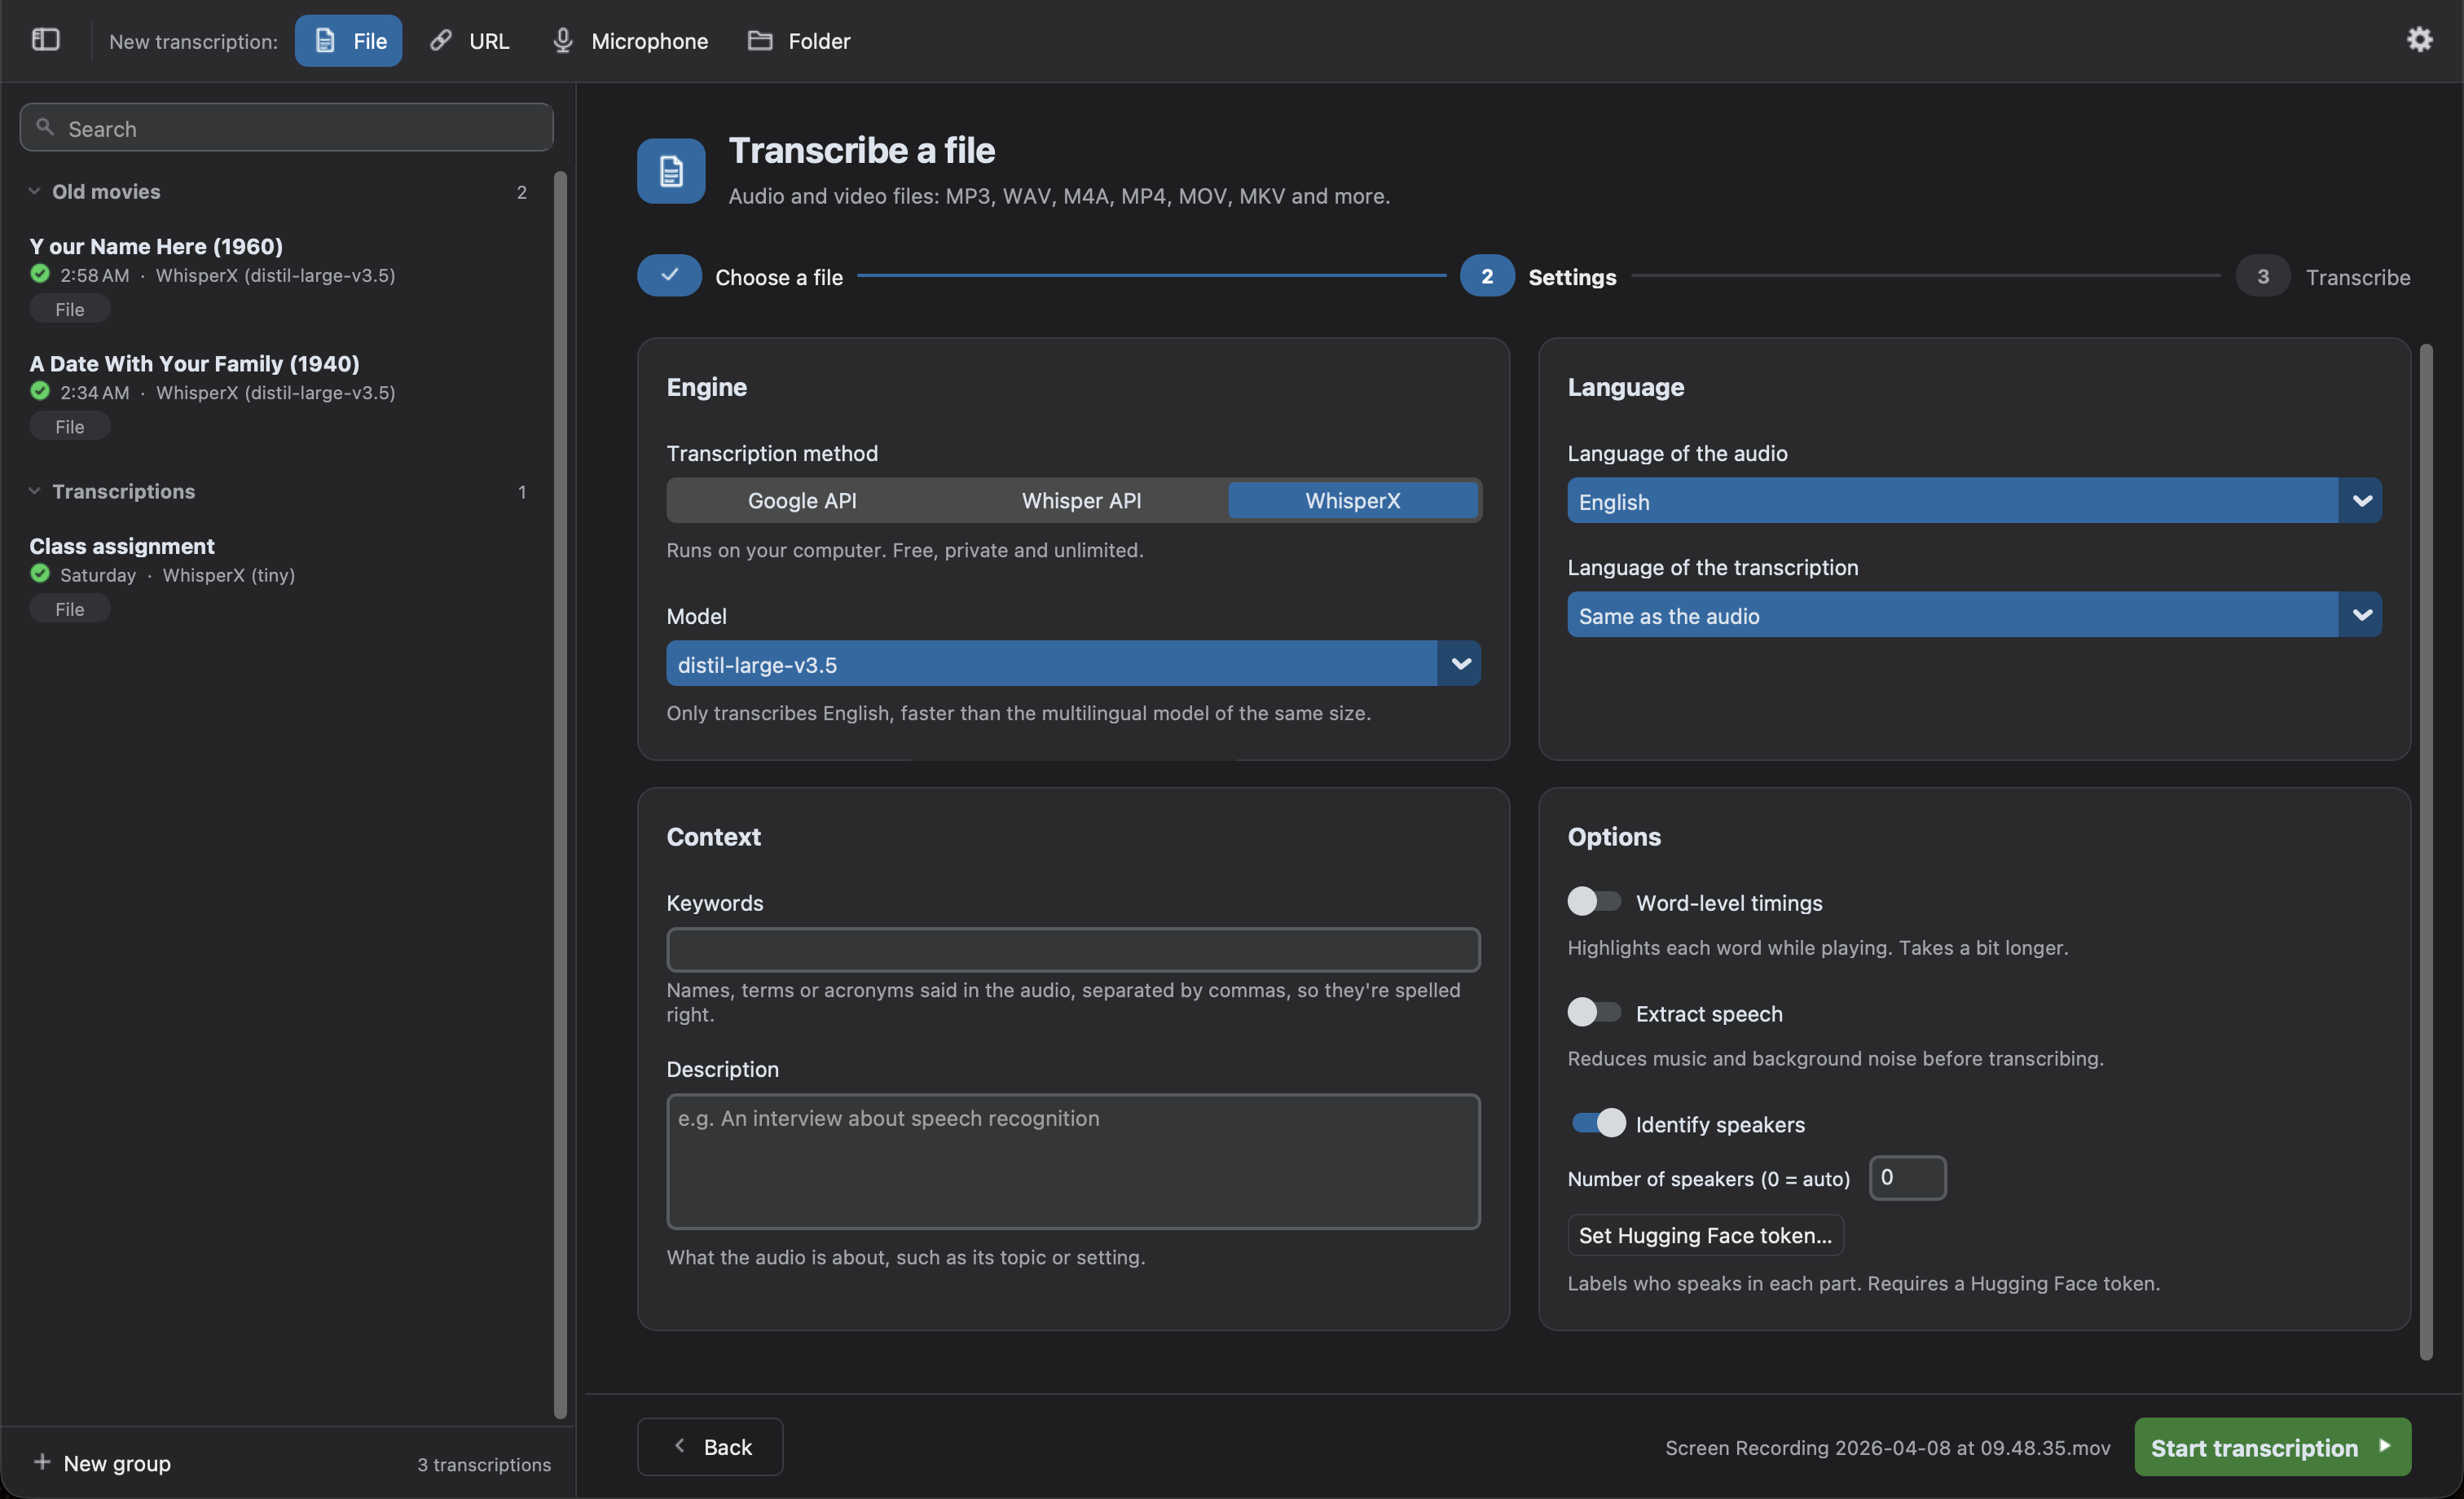
받아쓰기 방법:
| 엔진 | 실행 위치 | 비용 | 참고 |
|---|---|---|---|
| WhisperX(기본값) | 내 컴퓨터 | 무료, 무제한 | 비공개, 오프라인. 화자, 단어별 타이밍, 실시간 텍스트 등 옵션이 더 많습니다. Apple 실리콘 Mac에서는 GPU로 실행됩니다. |
| Whisper API | OpenAI 서버 | 분당 유료 | OpenAI API 키가 필요합니다. WhisperX가 원활히 실행되지 않는 컴퓨터용. |
| Google API | Google 서버 | 무료 등급 또는 유료 | 품질이 낮고 타임스탬프가 없습니다. API 키는 선택 사항입니다. |
모델은 엔진에 따라 다릅니다. WhisperX에서는 큰 모델일수록 정확하지만 느립니다. Whisper API에서는 받아쓰기에 타임스탬프와 화자가 포함되는지를 결정합니다. 비교는 엔진을 참고하세요.
- 오디오 언어: 기본값은 자동 감지입니다. 직접 고르면 짧거나 여러 언어가 섞인 오디오에서 오류를 줄일 수 있습니다. Google API는 감지할 수 없으므로 반드시 골라야 합니다.
- 받아쓰기 언어: 기본값은 오디오와 같음입니다. 다른 언어를 고르면 받아쓰면서 오디오를 번역합니다.
두 언어가 다르면 번역 옵션이 나타납니다.
- Whisper로 번역(권장): Whisper가 오디오를 한 번에 받아쓰고 번역합니다. 영어로만 번역할 수 있습니다.
- 해당 언어(언어)로 바로 작성(실험적): Whisper에게 그 언어로 바로 받아쓰도록 요청합니다. 많은 언어에서 잘 작동하지만 결과를 확인하세요.
Google API는 번역할 수 없습니다. 나중에 더 많은 제공자로 원하는 언어로 번역하려면 대본의 번역 버튼을 사용하세요.
모델을 돕는 두 가지 선택 항목입니다.
- 키워드: 오디오에 나오는 이름, 용어, 약어를 쉼표로 구분해 입력합니다(예:
Audiotext, WhisperX, Henestrosa). 철자가 올바르게 적히도록 돕습니다. 힌트일 뿐이며, 키워드는 오디오에서 말한 경우에만 적힙니다. - 설명: 오디오의 주제나 상황 등 내용입니다(예:
음성 인식에 관한 인터뷰).
WhisperX와 Whisper API에서 사용되며, gpt-4o-transcribe-diarize 모델은 예외입니다. Google API는 사용하지 않습니다.
- 단어별 타이밍(WhisperX): 각 단어를 오디오에 맞춰 재생 중 강조하고, 가장 확신하지 못하는 단어를 검토할 수 있게 합니다. 시간이 조금 더 걸립니다. 기본적으로 켜져 있습니다. 자막에는 단어 타이밍이 필요하므로, 폴더의 파일 형식에서
.srt나.vtt를 선택한 동안에는 켜지고 잠깁니다. 선택을 해제하면 원래 선택으로 돌아갑니다. - 배경 소음 줄이기: 받아쓰기 전에 험 노이즈와 일정한 배경 소음을 줄이고 작은 목소리를 고르게 합니다. 시간이 더 걸립니다.
- 화자 식별(WhisperX): 각 부분을 누가 말하는지 표시합니다(예:
SPEAKER_00). 말하는 사람 수를 알면 화자 수에 입력하세요(0은 자동 감지). 무료 Hugging Face 토큰이 필요합니다. 화자를 식별하려면을 참고하세요. Whisper API에서는gpt-4o-transcribe-diarize모델이 화자를 식별합니다.
화자를 식별하려면
섹션 제목: “화자를 식별하려면”화자를 식별하는 모델 pyannote/speaker-diarization-community-1은 무료지만 Hugging Face 토큰이 필요합니다.
- Hugging Face에서 계정을 만들고 pyannote/speaker-diarization-community-1의 이용 조건에 동의합니다.
- 설정에서
Read역할의 토큰을 만듭니다. - **Hugging Face 토큰 설정…**을 클릭하고 붙여넣습니다.
모델은 처음 사용할 때 다운로드됩니다. 그 이후에는 오프라인으로 화자를 식별합니다.
실시간 텍스트
섹션 제목: “실시간 텍스트”마이크에서만 표시됩니다. 실시간 텍스트를 참고하세요.
폴더와 출력
섹션 제목: “폴더와 출력”폴더에서만 표시됩니다.
- 폴더 감시: 폴더 감시를 참고하세요.
- 폴더에 이미 있는 파일 받아쓰기(감시 중에만): 폴더에 이미 있고 아직 받아쓰기가 없는 파일을 먼저 받아씁니다. 기본적으로 꺼져 있습니다.
- 하위 폴더 포함: 하위 폴더의 파일도 받아씁니다.
- 다음과 일치하는 파일 건너뛰기: 건너뛸 파일의 이름이나 경로를 쉼표로 구분해 입력합니다(예:
*.wav, drafts/*). 숨김 파일은 항상 건너뜁니다. - 파일 형식: WhisperX에서는
.txt,.srt,.vtt,.json,.tsv,.aud중 하나 이상. Whisper API에서는 파일 형식(text,json,verbose_json,srt,vtt)이며, 자막에는 타임스탬프를 반환하는 모델이 필요합니다. Google API는 일반 텍스트(.txt)를 반환합니다. - 위치: 파일은 각 원본 파일 옆에 저장됩니다. **변경…**을 클릭하면 다른 폴더에 저장하고(하위 폴더 구조는 다시 만들어집니다), 소스와 같은 위치를 클릭하면 되돌립니다.
이미 받아쓰기가 있는 파일은 건너뜁니다. 다시 받아쓰려면 폴더의 파일 옵션을 사용하세요.
자막 옵션(줄 너비, 줄 수, 단어 강조)은 환경설정에 있습니다.