

Ustawienia transkrypcji
Przed transkrypcją Audiotext pokazuje jej ustawienia pogrupowane w karty. Są zapamiętywane na kolejny raz, a każda transkrypcja zachowuje ustawienia, z którymi powstała.
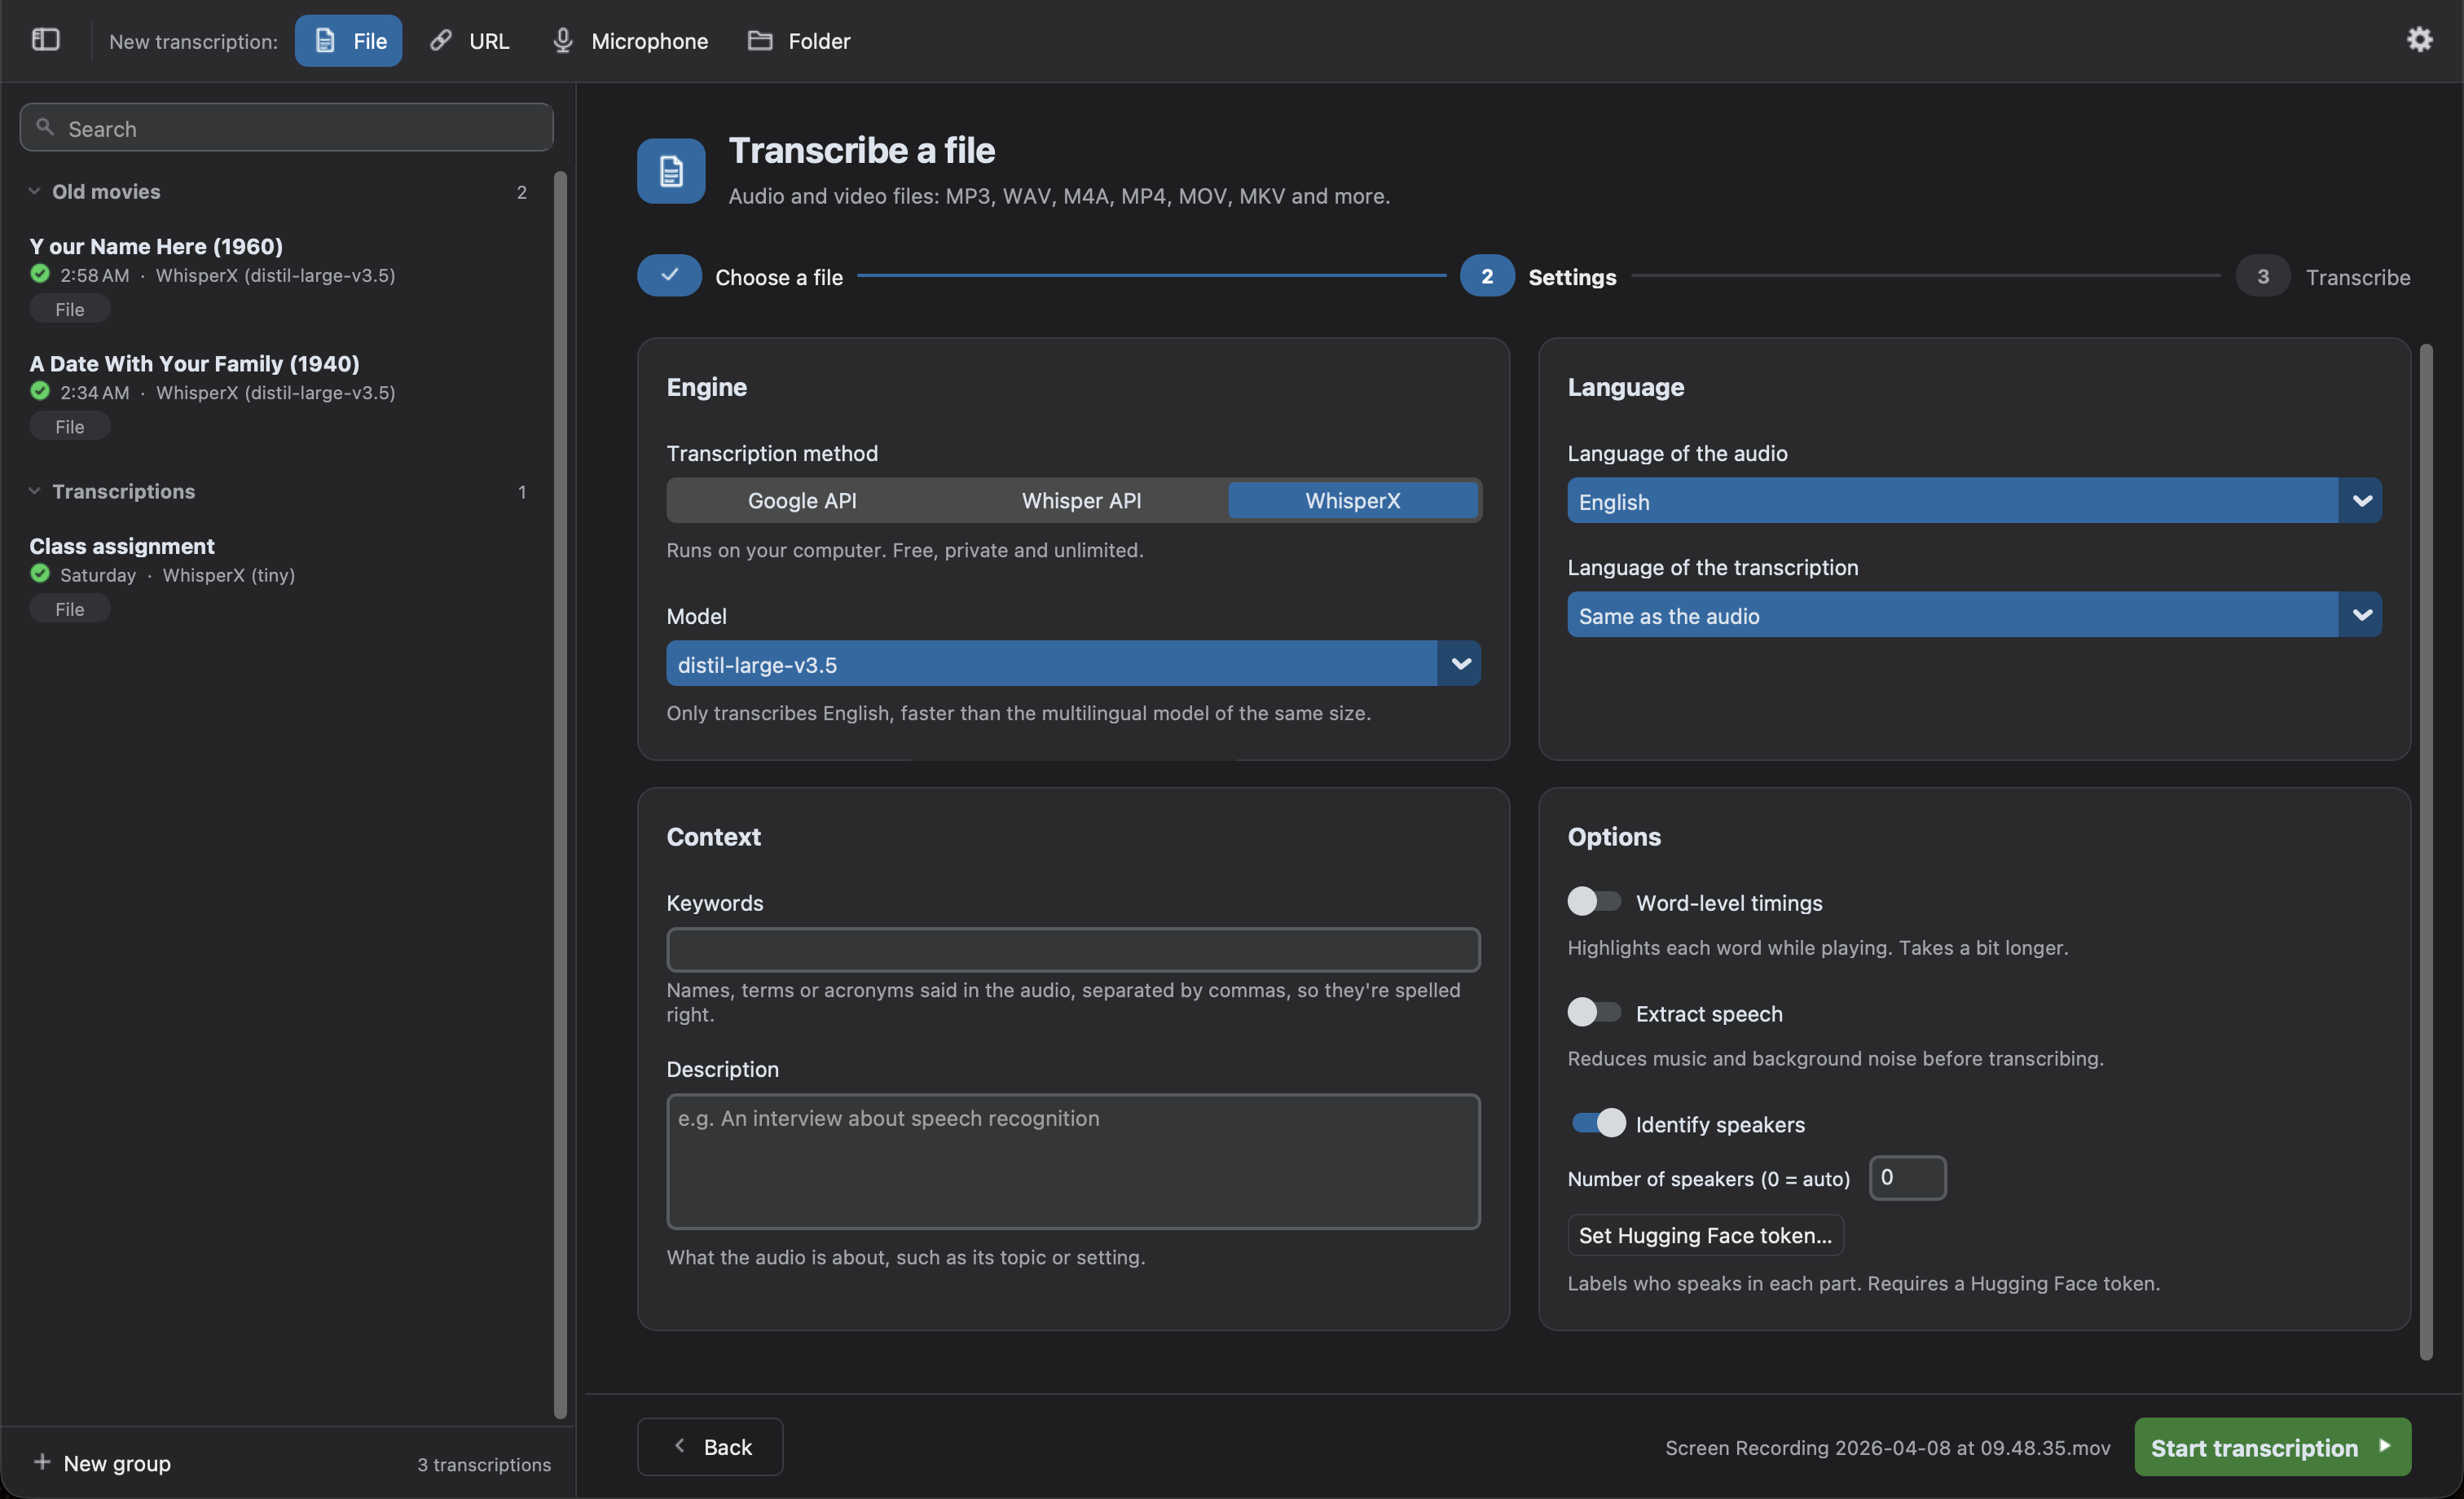
Metoda transkrypcji:
| Silnik | Gdzie działa | Koszt | Uwagi |
|---|---|---|---|
| WhisperX (domyślny) | Twój komputer | Za darmo i bez limitów | Prywatnie i offline. Więcej opcji: mówcy, czasy słów, tekst na żywo. Działa na karcie graficznej Maców z Apple Silicon. |
| API Whisper | Serwery OpenAI | Płatny za minutę | Wymaga klucza API OpenAI. Dla komputerów, na których WhisperX nie działa płynnie. |
| API Google | Serwery Google | Darmowy limit lub płatny | Niższa jakość i brak znaczników czasu. Klucz API jest opcjonalny. |
Model zależy od silnika. W WhisperX większe modele są dokładniejsze, ale wolniejsze. W API Whisper decyduje, czy transkrypcja ma znaczniki czasu i mówców. Porównanie znajdziesz w sekcji Silniki.
- Język nagrania: domyślnie Wykryj automatycznie. Wybranie go pozwala uniknąć błędów w krótkich lub mieszanych nagraniach. API Google nie potrafi go wykryć, więc trzeba go wybrać.
- Język transkrypcji: domyślnie Taki sam jak nagranie. Wybierz inny język, aby przetłumaczyć nagranie podczas transkrypcji.
Gdy języki się różnią, pojawiają się opcje w sekcji Tłumaczenie:
- Tłumacz za pomocą Whisper (zalecane): Whisper transkrybuje i tłumaczy nagranie w jednym kroku. Tłumaczy tylko na angielski.
- Zapisz bezpośrednio w języku: język (eksperymentalne): Whisper otrzymuje polecenie zapisania transkrypcji bezpośrednio w tym języku. W wielu językach działa to dobrze, ale sprawdź wynik.
API Google nie tłumaczy. Aby później przetłumaczyć transkrypcję na dowolny język, korzystając z większej liczby dostawców, użyj przycisku Przetłumacz w transkrypcji.
Kontekst
Dział zatytułowany „Kontekst”Dwa opcjonalne pola, które pomagają modelowi:
- Słowa kluczowe: nazwy, terminy lub skróty wypowiadane w nagraniu, oddzielone przecinkami (np.
Audiotext, WhisperX, Henestrosa), aby były poprawnie zapisane. To tylko podpowiedzi: słowo kluczowe zostanie zapisane tylko wtedy, gdy pada w nagraniu. - Opis: o czym jest nagranie, np. jego temat lub okoliczności (np.
Wywiad o rozpoznawaniu mowy).
Używają ich WhisperX i API Whisper, z wyjątkiem modelu gpt-4o-transcribe-diarize. API Google ich nie używa.
- Czasy poszczególnych słów (WhisperX): wyrównuje każde słowo z nagraniem, aby wyróżniać je podczas odtwarzania i sprawdzać słowa, których jest najmniej pewny. Trwa nieco dłużej. Domyślnie włączone. Napisy potrzebują czasów słów, więc opcja jest włączona i zablokowana, dopóki w polu Typy plików folderu wybrano
.srtlub.vtt; twój wybór wraca, gdy przestaną być wybrane. - Redukuj szum tła: przed transkrypcją redukuje buczenie i stały szum tła oraz wyrównuje cichą mowę. Trwa dłużej.
- Rozpoznawaj mówców (WhisperX): oznacza, kto mówi w każdej części, np.
SPEAKER_00. Jeśli wiesz, ile osób mówi, wpisz to w polu Liczba mówców (0wykrywa automatycznie). Wymaga darmowego tokenu Hugging Face; zobacz Rozpoznawanie mówców. W API Whisper mówców rozpoznaje modelgpt-4o-transcribe-diarize.
Rozpoznawanie mówców
Dział zatytułowany „Rozpoznawanie mówców”Model rozpoznający mówców, pyannote/speaker-diarization-community-1, jest darmowy, ale wymaga tokenu Hugging Face:
- Załóż konto w Hugging Face i zaakceptuj warunki pyannote/speaker-diarization-community-1.
- Utwórz token z rolą
Readw swoich ustawieniach. - Kliknij Ustaw token Hugging Face… i wklej go.
Model jest pobierany przy pierwszym użyciu. Potem mówcy są rozpoznawani offline.
Tekst na żywo
Dział zatytułowany „Tekst na żywo”Widoczny tylko dla mikrofonu. Zobacz Tekst na żywo.
Folder i Wynik
Dział zatytułowany „Folder i Wynik”Widoczne tylko dla folderów:
- Obserwuj folder: zobacz Obserwuj folder.
- Transkrybuj pliki, które już są w folderze (tylko podczas obserwowania): najpierw transkrybuje pliki, które już są w folderze i nie mają jeszcze transkrypcji. Domyślnie wyłączone.
- Uwzględnij podfoldery: transkrybuje też pliki z podfolderów.
- Pomiń pliki pasujące do: nazwy lub ścieżki plików do pominięcia, oddzielone przecinkami (np.
*.wav, drafts/*). Ukryte pliki są zawsze pomijane. - Typy plików: w WhisperX jeden lub więcej spośród
.txt,.srt,.vtt,.json,.tsvi.aud. W API Whisper format plików (text,json,verbose_json,srtlubvtt); napisy wymagają modelu ze znacznikami czasu. API Google zwraca zwykły tekst (.txt). - Lokalizacja: pliki są zapisywane obok każdego pliku źródłowego. Kliknij Zmień…, aby zapisać je w innym folderze (jego podfoldery zostaną odtworzone), lub Obok źródła, aby wrócić.
Pliki, które mają już transkrypcję, są pomijane. Aby transkrybować je ponownie, użyj opcji plików folderu.
Opcje napisów (szerokość wiersza, liczba wierszy, wyróżnione słowa) znajdują się w Preferencjach.