

转写设置
转写之前,Audiotext 会以卡片形式显示转写设置。这些设置会记住供下次使用,每个转写也会保存创建时所用的设置。
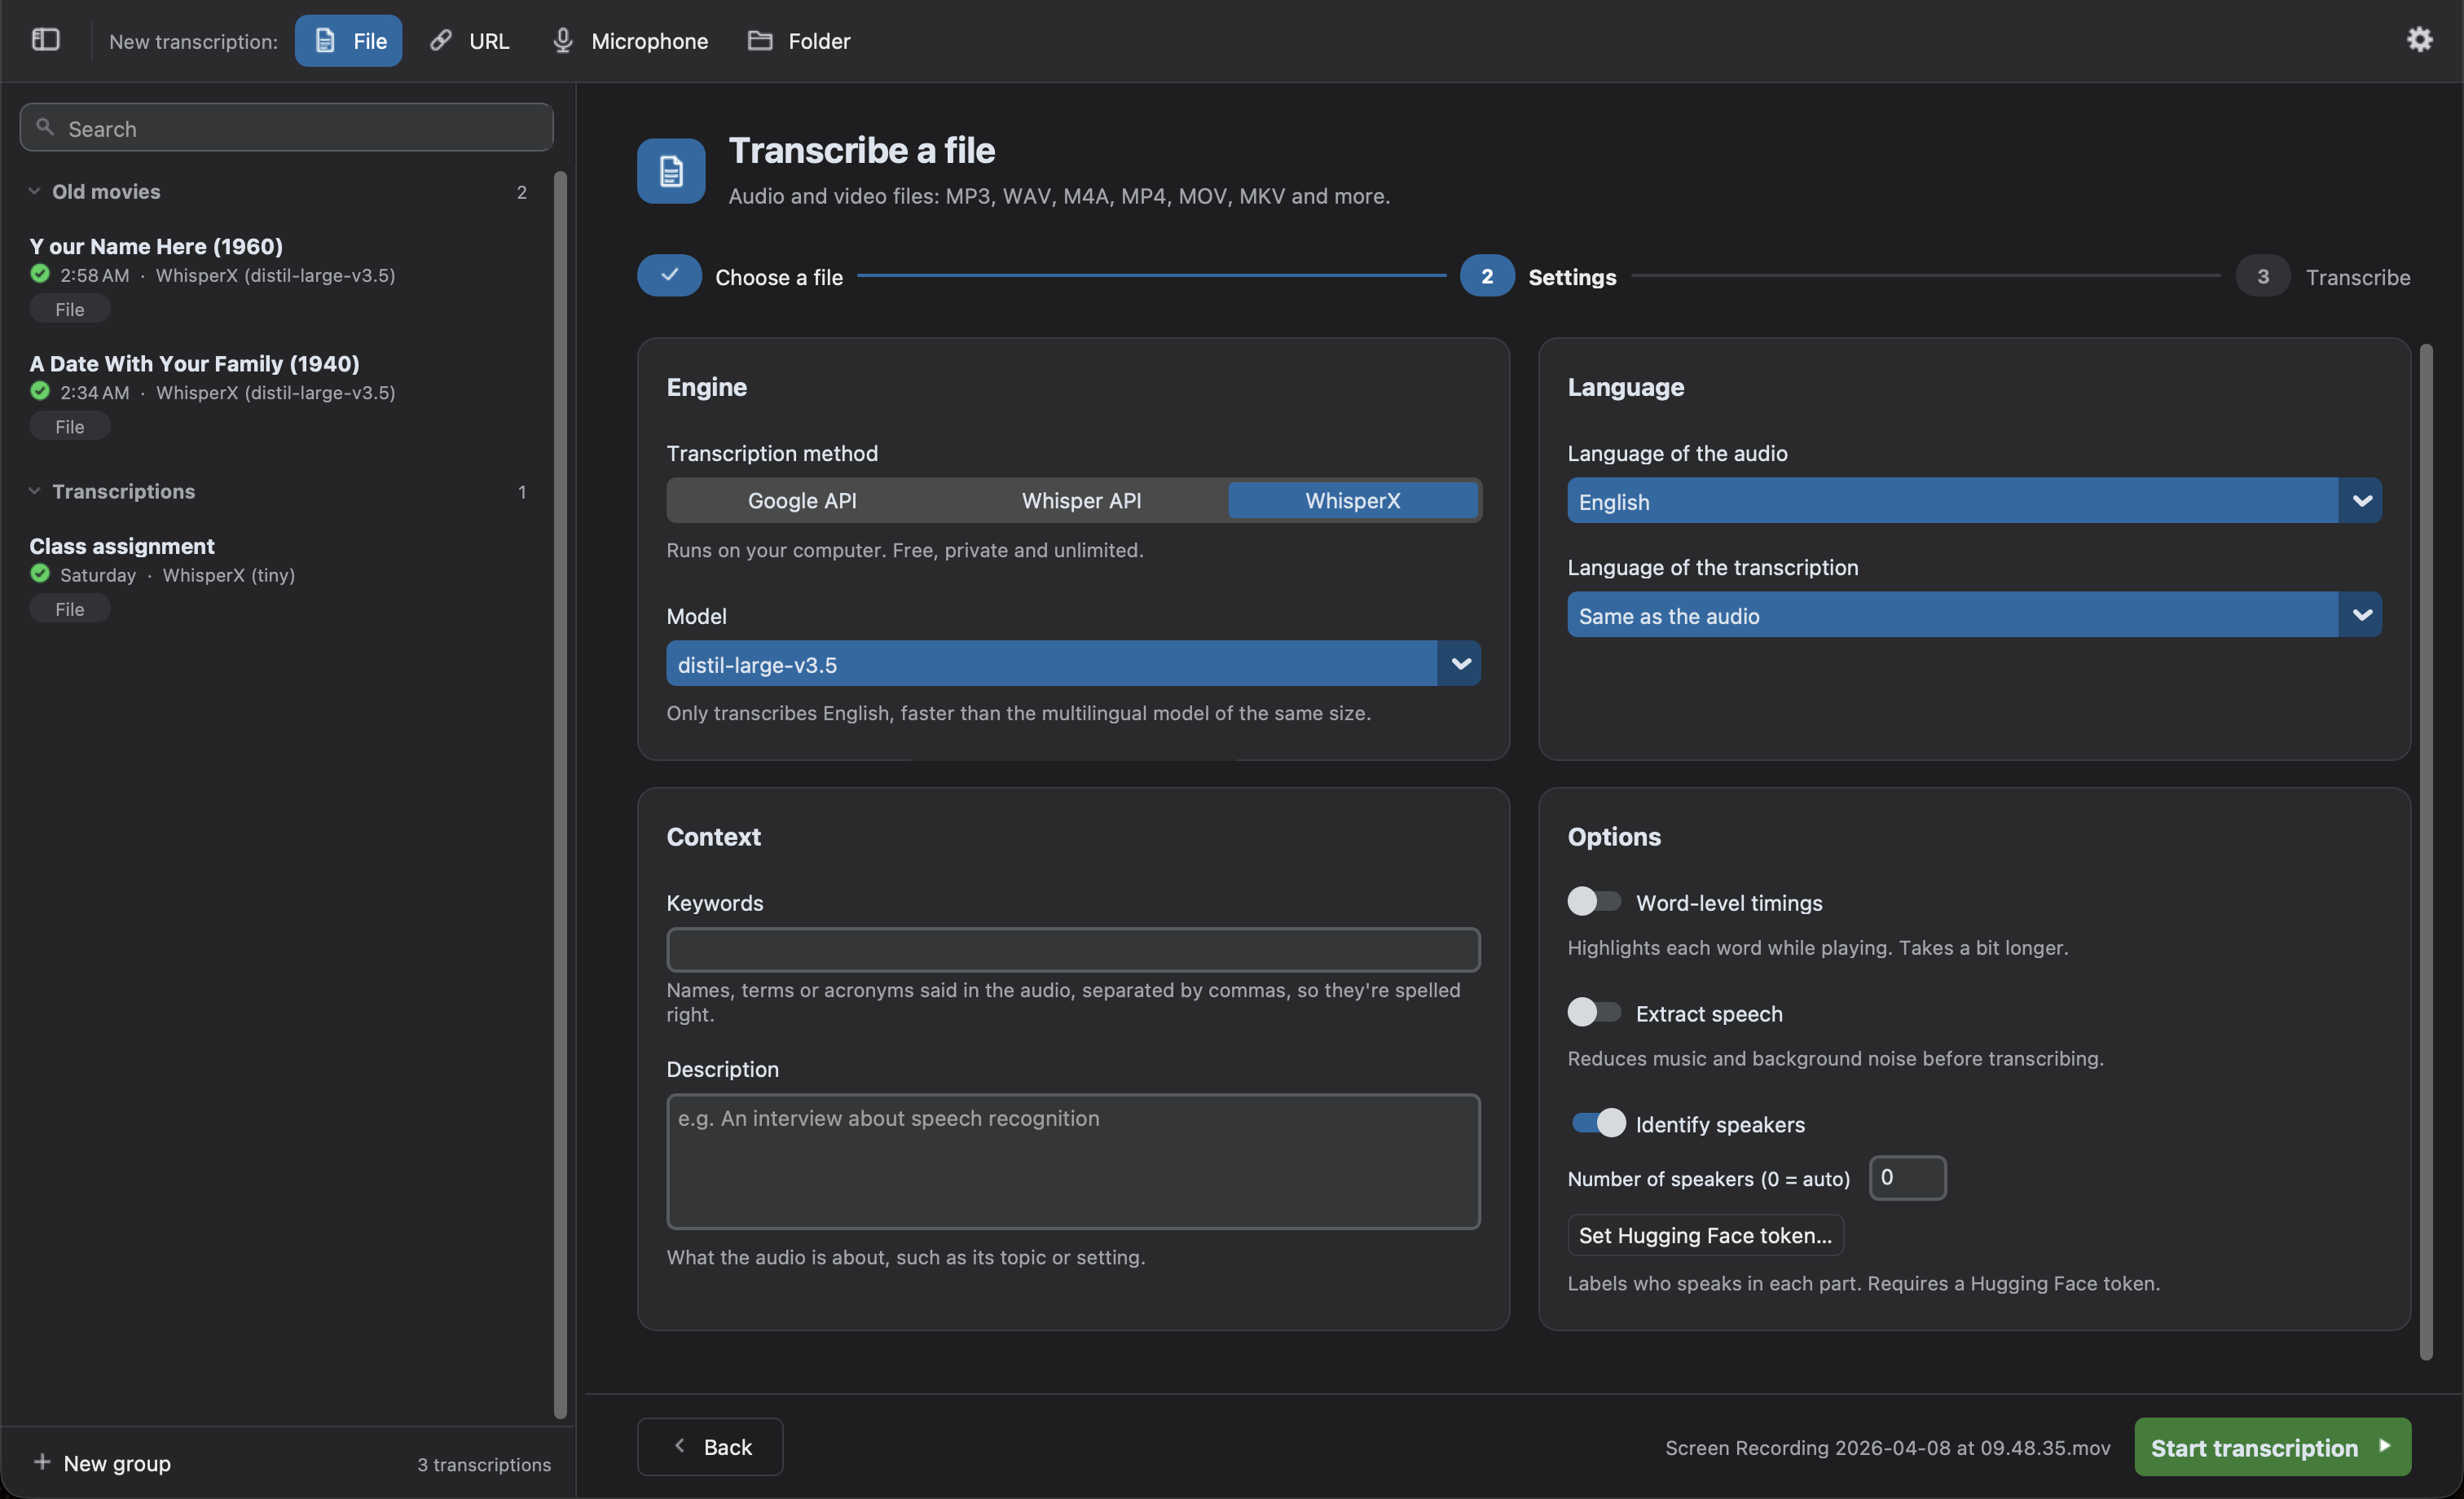
转写方式:
| 引擎 | 运行位置 | 费用 | 说明 |
|---|---|---|---|
| WhisperX(默认) | 你的电脑 | 免费、不限量 | 私密、可离线。选项更多:说话人、逐词时间、实时文本。在搭载 Apple 芯片的 Mac 上使用 GPU 运行。 |
| Whisper API | OpenAI 服务器 | 按分钟付费 | 需要 OpenAI API 密钥。适合无法流畅运行 WhisperX 的电脑。 |
| Google API | Google 服务器 | 免费额度或付费 | 质量较低,且没有时间戳。API 密钥可选。 |
模型取决于引擎。对于 WhisperX,模型越大越准确,但也越慢。对于 Whisper API,模型决定转写是否包含时间戳和说话人。比较请参阅引擎。
- 音频语言:默认为自动检测。手动选择可避免较短或混合语言音频中的错误。Google API 无法检测语言,因此必须手动选择。
- 转写语言:默认为与音频相同。选择其他语言可在转写的同时翻译音频。
两种语言不同时,会出现翻译选项:
- 使用 Whisper 翻译(推荐):Whisper 一步完成转写和翻译。只能翻译成英语。
- 直接用_语言_书写(实验性):要求 Whisper 直接用该语言书写转写。对许多语言效果不错,但请检查结果。
Google API 无法翻译。之后若要用更多提供商翻译成任意语言,请使用逐字稿中的翻译按钮。
两个可选字段,用于帮助模型:
- 关键词:音频中出现的人名、术语或缩写,用逗号分隔(例如
Audiotext, WhisperX, Henestrosa),使其拼写正确。它们只是提示:只有在音频中说到时才会写出。 - 描述:音频的内容,例如主题或场景(例如
一次关于语音识别的访谈)。
WhisperX 和 Whisper API 会使用它们,但 gpt-4o-transcribe-diarize 模型除外。Google API 不使用它们。
- 逐词时间(WhisperX):将每个字词与音频对齐,以便播放时高亮,并用于检查它最没有把握的词。会稍微多花一点时间。默认开启。字幕需要单词的时间,因此当文件夹的文件类型中选择了
.srt或.vtt时,此选项会被开启并锁定;不再选择它们时,会恢复你自己的选择。 - 降低背景噪音:在转写前降低嗡嗡声和持续的背景噪音,并使轻声的语音更均匀。耗时更长。
- 识别说话人(WhisperX):标注每一段由谁说话,例如
SPEAKER_00。如果知道有几个人说话,请在说话人数量中填写(0表示自动检测)。需要免费的 Hugging Face 令牌;请参阅识别说话人的设置。在 Whisper API 中,由gpt-4o-transcribe-diarize模型识别说话人。
识别说话人的设置
Section titled “识别说话人的设置”识别说话人的模型 pyannote/speaker-diarization-community-1 是免费的,但需要 Hugging Face 令牌:
- 在 Hugging Face 创建账号,并接受 pyannote/speaker-diarization-community-1 的使用条款。
- 在你的设置中创建一个角色为
Read的令牌。 - 点击**设置 Hugging Face 令牌…**并粘贴。
模型会在首次使用时下载。之后识别说话人可离线完成。
仅在麦克风来源中显示。请参阅实时文本。
文件夹与输出
Section titled “文件夹与输出”仅在文件夹来源中显示:
- 监视文件夹:请参阅监视文件夹。
- 转写文件夹中已有的文件(仅在监视时):先转写文件夹中已有且还没有转写的文件。默认关闭。
- 包含子文件夹:也转写子文件夹中的文件。
- 跳过匹配以下内容的文件:要跳过的文件的名称或路径,用逗号分隔(例如
*.wav, drafts/*)。隐藏文件总是会被跳过。 - 文件类型:使用 WhisperX 时,可选
.txt、.srt、.vtt、.json、.tsv和.aud中的一种或多种。使用 Whisper API 时,为文件格式(text、json、verbose_json、srt或vtt);字幕需要能返回时间戳的模型。Google API 返回纯文本(.txt)。 - 位置:文件保存在每个源文件旁边。点击更改…可保存到其他文件夹(会重建子文件夹结构),点击与来源相同的位置可恢复。
已有转写的文件会被跳过。要重新转写它们,请使用文件夹中的文件中的选项。
字幕选项(行宽、行数、高亮单词)位于偏好设置中。