

Configuración da transcrición
Antes de transcribir, Audiotext mostra a configuración da transcrición, agrupada en tarxetas. Lémbrase para a próxima vez, e cada transcrición garda a configuración coa que se fixo.
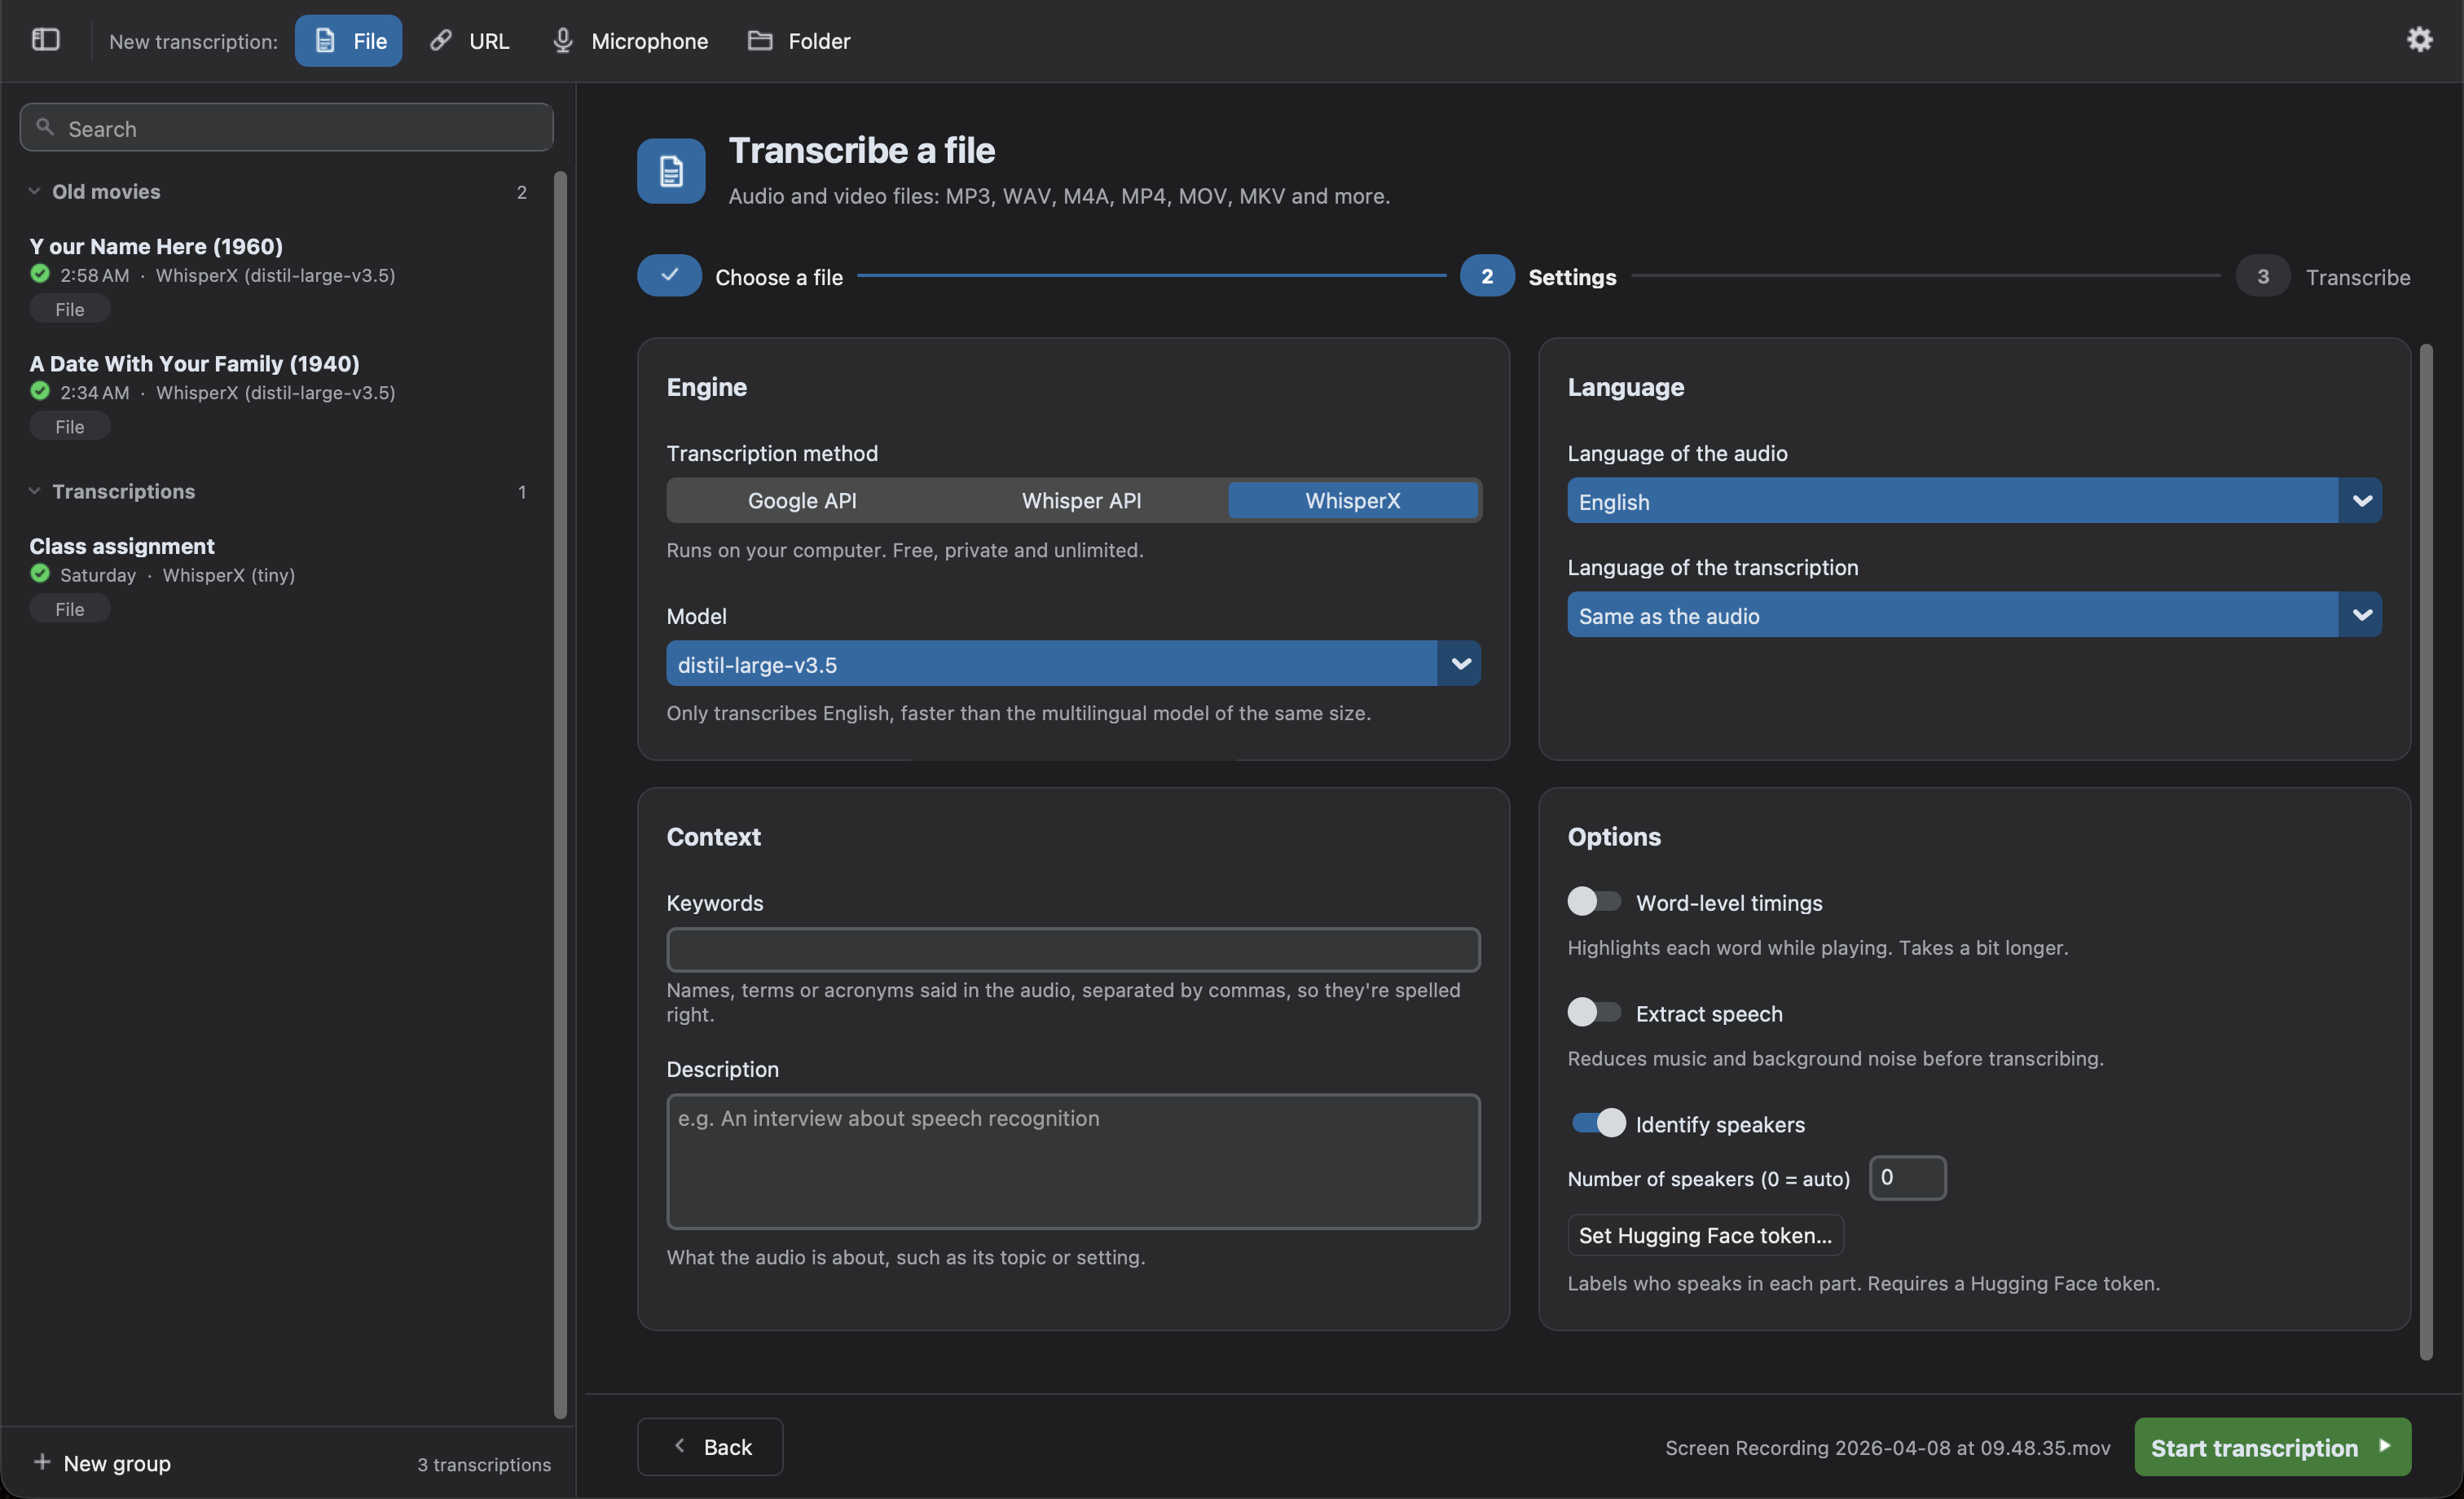
O Método de transcrición:
| Motor | Onde se executa | Custo | Notas |
|---|---|---|---|
| WhisperX (predeterminado) | O teu ordenador | De balde e sen límites | Privado e sen conexión. Máis opcións: falantes, tempos por palabra, texto en directo. Funciona na GPU dos Mac con Apple Silicon. |
| API de Whisper | Servidores de OpenAI | De pagamento por minuto | Require unha clave de API de OpenAI. Para ordenadores que non poden executar WhisperX con fluidez. |
| API de Google | Servidores de Google | Gratuíta limitada, ou de pagamento | Menor calidade e sen marcas de tempo. A clave de API é opcional. |
O Modelo depende do motor. Con WhisperX, os modelos máis grandes son máis precisos, pero máis lentos. Coa API de Whisper, decide se a transcrición ten marcas de tempo e falantes. Consulta Motores para comparalos.
- Idioma do audio: Detectar automaticamente de forma predeterminada. Escollelo evita erros en audios curtos ou mesturados. A API de Google non pode detectalo, así que tes que escollelo.
- Idioma da transcrición: O mesmo que o audio de forma predeterminada. Escolle outro idioma para traducir o audio mentres se transcribe.
Cando os dous idiomas son distintos, aparecen as opcións de Tradución:
- Traducir con Whisper (recomendado): Whisper transcribe e traduce o audio nun só paso. Só pode traducir ao inglés.
- Escribila directamente en idioma (experimental): pídeselle a Whisper que escriba a transcrición directamente nese idioma. Funciona ben en moitos idiomas, pero revisa o resultado.
A API de Google non pode traducir. Para traducir unha transcrición a calquera idioma máis tarde, con máis provedores, usa o botón Traducir da transcrición.
Contexto
Sección titulada «Contexto»Dous campos opcionais que axudan ao modelo:
- Palabras clave: nomes, termos ou siglas que se din no audio, separados por comas (p. ex.
Audiotext, WhisperX, Henestrosa), para que se escriban ben. Son só pistas: unha palabra clave só se escribe se se di no audio. - Descrición: de que trata o audio, como o seu tema ou o seu contexto (p. ex.
Unha entrevista sobre recoñecemento de voz).
Úsanos WhisperX e a API de Whisper, agás o modelo gpt-4o-transcribe-diarize. A API de Google non os usa.
Opcións
Sección titulada «Opcións»- Tempos por palabra (WhisperX): aliña cada palabra co audio, para resaltala ao reproducir e para revisar as palabras das que está menos seguro. Tarda un pouco máis. Activado de forma predeterminada. Os subtítulos precisan os tempos das palabras, así que se activa e se bloquea mentres
.srtou.vttestán escollidos nos Tipos de ficheiro dun cartafol; a túa escolla volve cando deixan de estalo. - Reducir o ruído de fondo: reduce o zumbido e o ruído de fondo constante, e iguala a voz baixa, antes de transcribir. Tarda máis.
- Identificar falantes (WhisperX): indica quen fala en cada parte, p. ex.
SPEAKER_00. Se sabes cantas persoas falan, indícao en Número de falantes (0detéctao). Require un token gratuíto de Hugging Face; consulta Identifica os falantes. Coa API de Whisper, o modelogpt-4o-transcribe-diarizeidentifica os falantes.
Identifica os falantes
Sección titulada «Identifica os falantes»O modelo que identifica os falantes, pyannote/speaker-diarization-community-1, é gratuíto, pero require un token de Hugging Face:
- Crea unha conta en Hugging Face e acepta as condicións de pyannote/speaker-diarization-community-1.
- Crea un token co rol
Readna túa configuración. - Fai clic en Configurar o token de Hugging Face… e pégao.
O modelo descárgase a primeira vez que se usa. Despois, os falantes identifícanse sen conexión.
Texto en directo
Sección titulada «Texto en directo»Só se mostra para o micrófono. Consulta Texto en directo.
Cartafol e Saída
Sección titulada «Cartafol e Saída»Só se mostran para cartafoles:
- Vixiar o cartafol: consulta Vixía un cartafol.
- Transcribir os ficheiros que xa hai no cartafol (só ao vixiar): primeiro transcribe os ficheiros que xa contén o cartafol e que aínda non teñen transcrición. Desactivado por defecto.
- Incluír subcartafoles: tamén transcribe os ficheiros dos subcartafoles.
- Omitir os ficheiros que coincidan con: nomes ou rutas dos ficheiros que se omiten, separados por comas (p. ex.
*.wav, drafts/*). Os ficheiros ocultos sempre se omiten. - Tipos de ficheiro: con WhisperX, un ou varios de
.txt,.srt,.vtt,.json,.tsve.aud. Coa API de Whisper, o formato dos ficheiros (text,json,verbose_json,srtouvtt); os subtítulos precisan un modelo con marcas de tempo. A API de Google devolve texto plano (.txt). - Localización: os ficheiros gárdanse xunto a cada ficheiro de orixe. Fai clic en Cambiar… para gardalos noutro cartafol (recréanse os seus subcartafoles), ou en Xunto á orixe para volver.
Os ficheiros que xa teñen unha transcrición omítense. Para transcribilos de novo, usa as opcións dos ficheiros do cartafol.
As opcións dos subtítulos (largura de liña, número de liñas, palabras resaltadas) están nas Preferencias.