

Setările transcrierii
Înainte de a transcrie, Audiotext afișează setările transcrierii, grupate în carduri. Acestea sunt reținute pentru data viitoare, iar fiecare transcriere păstrează setările cu care a fost făcută.
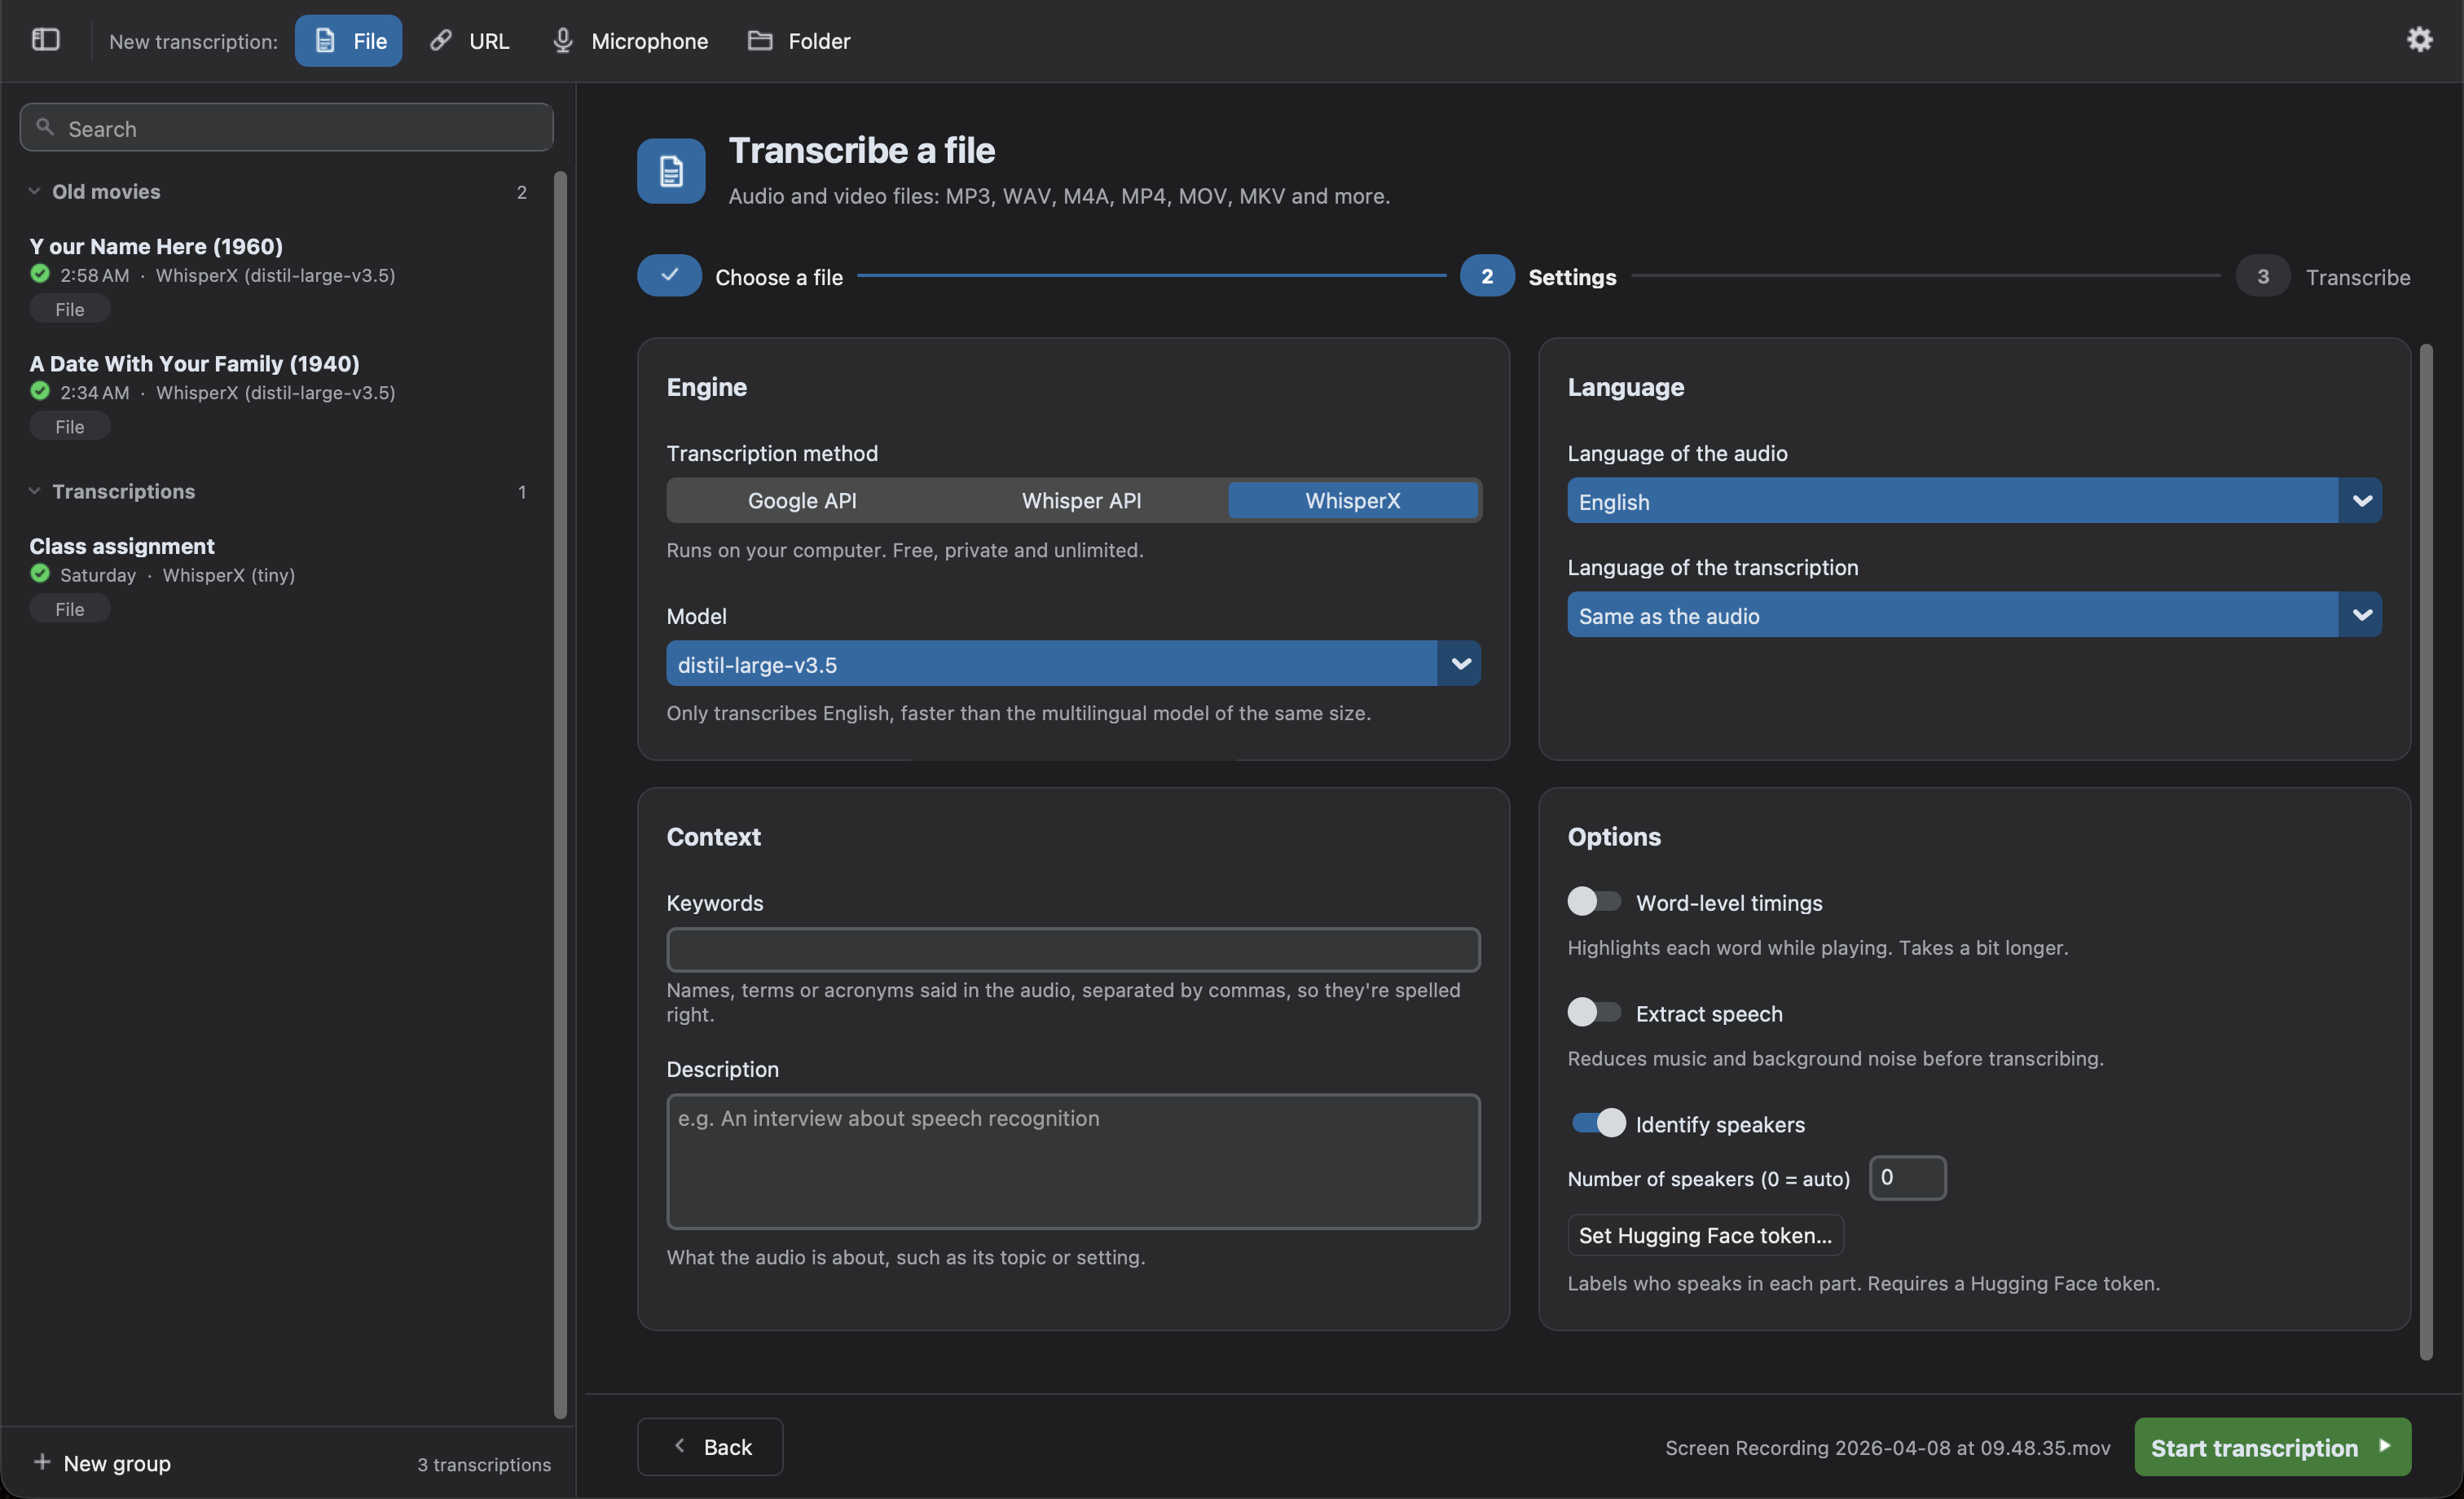
Metodă de transcriere:
| Motor | Unde rulează | Cost | Observații |
|---|---|---|---|
| WhisperX (implicit) | Computerul dumneavoastră | Gratuit și nelimitat | Privat și offline. Mai multe opțiuni: vorbitori, temporizare pe cuvânt, text live. Rulează pe placa video a Mac-urilor cu Apple Silicon. |
| API Whisper | Serverele OpenAI | Plătit pe minut | Necesită o cheie API OpenAI. Pentru computerele care nu rulează WhisperX fluent. |
| API Google | Serverele Google | Nivel gratuit sau plătit | Calitate mai slabă și fără marcaje de timp. Cheia API este opțională. |
Modelul depinde de motor. La WhisperX, modelele mai mari sunt mai precise, dar mai lente. La API-ul Whisper, determină dacă transcrierea are marcaje de timp și vorbitori. Comparați-le în Motoare.
- Limba audio: implicit Detectare automată. Alegerea ei evită erorile în înregistrările scurte sau mixte. API-ul Google nu o poate detecta, așa că trebuie să o alegeți.
- Limba transcrierii: implicit La fel ca audio. Alegeți altă limbă pentru a traduce sunetul în timpul transcrierii.
Când limbile diferă, apar opțiunile de Traducere:
- Tradu cu Whisper (recomandat): Whisper transcrie și traduce sunetul într-un singur pas. Poate traduce doar în engleză.
- Scrie-o direct în limba: limba (experimental): i se cere lui Whisper să scrie transcrierea direct în acea limbă. Funcționează bine pentru multe limbi, dar verificați rezultatul.
API-ul Google nu poate traduce. Pentru a traduce ulterior o transcriere în orice limbă, cu mai mulți furnizori, folosiți butonul Tradu al transcrierii.
Două câmpuri opționale care ajută modelul:
- Cuvinte cheie: nume, termeni sau acronime rostite în înregistrare, separate prin virgulă (de ex.
Audiotext, WhisperX, Henestrosa), ca să fie scrise corect. Sunt doar indicii: un cuvânt cheie este scris doar dacă este rostit. - Descriere: despre ce este înregistrarea, de exemplu subiectul sau cadrul (de ex.
Un interviu despre recunoașterea vorbirii).
Sunt folosite de WhisperX și de API-ul Whisper, cu excepția modelului gpt-4o-transcribe-diarize. API-ul Google nu le folosește.
- Temporizare pe cuvânt (WhisperX): aliniază fiecare cuvânt cu sunetul, pentru a-l evidenția la redare și pentru a verifica cuvintele de care este cel mai puțin sigur. Durează puțin mai mult. Activată implicit. Subtitrările au nevoie de temporizarea cuvintelor, așa că opțiunea este activată și blocată cât timp
.srtsau.vttsunt alese în Tipuri de fișiere ale unui dosar; alegerea dvs. revine când nu mai sunt alese. - Reduce zgomotul de fond: reduce bâzâitul și zgomotul de fond constant și egalizează vorbirea încetă, înainte de transcriere. Durează mai mult.
- Identifică vorbitorii (WhisperX): indică cine vorbește în fiecare parte, de ex.
SPEAKER_00. Dacă știți câte persoane vorbesc, introduceți numărul în Număr de vorbitori (0îl detectează). Necesită un token Hugging Face gratuit; consultați Identificarea vorbitorilor. La API-ul Whisper, vorbitorii sunt identificați de modelulgpt-4o-transcribe-diarize.
Identificarea vorbitorilor
Secțiune intitulată „Identificarea vorbitorilor”Modelul care identifică vorbitorii, pyannote/speaker-diarization-community-1, este gratuit, dar necesită un token Hugging Face:
- Creați un cont pe Hugging Face și acceptați condițiile pyannote/speaker-diarization-community-1.
- Creați un token cu rolul
Readîn setările dumneavoastră. - Faceți clic pe Setează tokenul Hugging Face… și lipiți-l.
Modelul este descărcat la prima utilizare. Apoi vorbitorii sunt identificați offline.
Text live
Secțiune intitulată „Text live”Afișat doar pentru microfon. Consultați Text live.
Dosar și Ieșire
Secțiune intitulată „Dosar și Ieșire”Afișate doar pentru dosare:
- Monitorizează dosarul: consultați Monitorizați un dosar.
- Transcrie fișierele aflate deja în dosar (doar în timpul monitorizării): transcrie mai întâi fișierele pe care dosarul le conține deja și care nu au încă o transcriere. Dezactivat implicit.
- Include subdosarele: transcrie și fișierele din subdosare.
- Omite fișierele care corespund cu: numele sau căile fișierelor de omis, separate prin virgule (de ex.
*.wav, drafts/*). Fișierele ascunse sunt omise întotdeauna. - Tipuri de fișiere: la WhisperX, unul sau mai multe dintre
.txt,.srt,.vtt,.json,.tsvși.aud. La API-ul Whisper, formatul fișierelor (text,json,verbose_json,srtsauvtt); subtitrările necesită un model cu marcaje de timp. API-ul Google returnează text simplu (.txt). - Locație: fișierele sunt salvate lângă fiecare fișier sursă. Faceți clic pe Schimbă… pentru a le salva în alt dosar (subdosarele lui sunt recreate) sau pe Lângă sursă pentru a reveni.
Fișierele care au deja o transcriere sunt omise. Pentru a le transcrie din nou, folosiți opțiunile fișierelor dosarului.
Opțiunile subtitrărilor (lățimea rândului, numărul de rânduri, cuvintele evidențiate) sunt în Preferințe.