

Настройки транскрипции
Перед транскрипцией Audiotext показывает её настройки, сгруппированные в карточки. Они запоминаются на следующий раз, а каждая транскрипция сохраняет настройки, с которыми она была сделана.
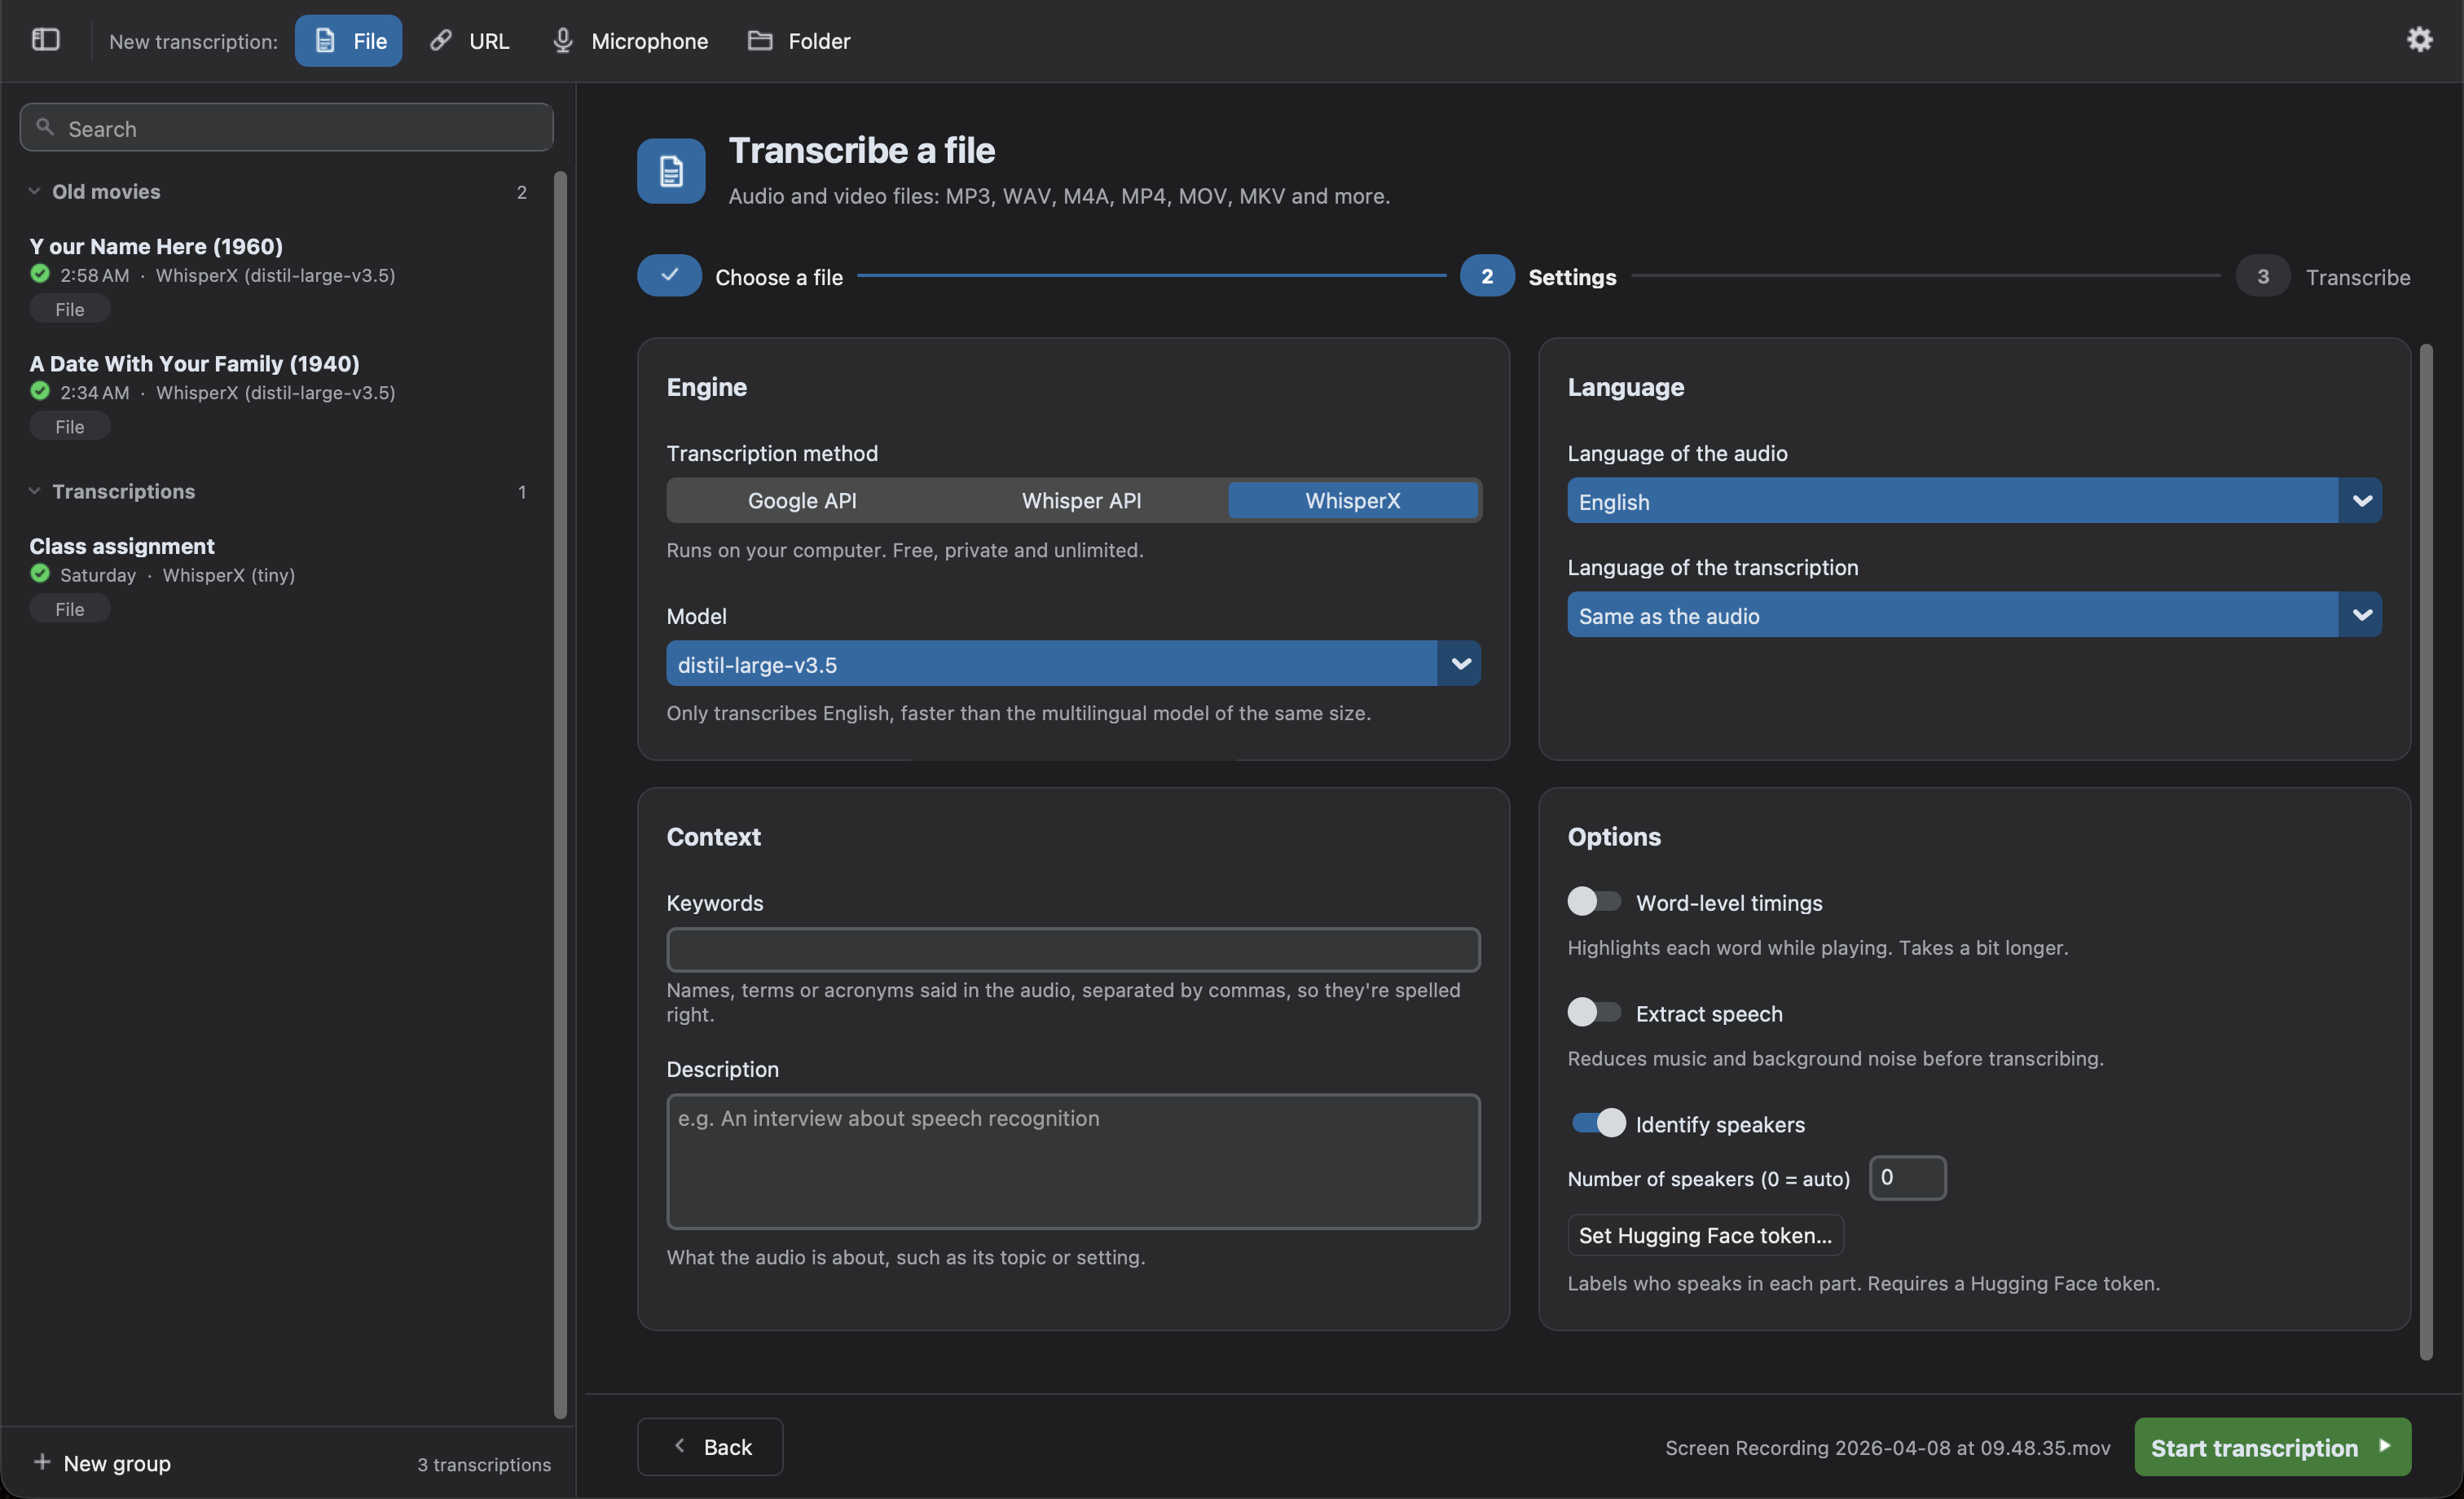
Метод транскрипции:
| Движок | Где работает | Стоимость | Примечания |
|---|---|---|---|
| WhisperX (по умолчанию) | Ваш компьютер | Бесплатно и без ограничений | Приватно и офлайн. Больше возможностей: говорящие, тайминг слов, живой текст. Работает на графическом процессоре Mac с Apple Silicon. |
| Whisper API | Серверы OpenAI | Оплата за минуту | Нужен ключ API OpenAI. Для компьютеров, на которых WhisperX работает медленно. |
| Google API | Серверы Google | Бесплатный лимит или платно | Ниже качество и нет временных меток. Ключ API необязателен. |
Модель зависит от движка. У WhisperX большие модели точнее, но медленнее. У Whisper API модель определяет, будут ли в транскрипции временные метки и говорящие. Сравнение — в разделе Движки.
- Язык аудио: по умолчанию Автоопределение. Если выбрать его вручную, можно избежать ошибок в коротких или смешанных записях. Google API не умеет определять язык, поэтому для него язык нужно выбрать.
- Язык транскрипции: по умолчанию Как у аудио. Выберите другой язык, чтобы перевести аудио во время транскрипции.
Если языки различаются, появляются параметры раздела Перевод:
- Переводить с помощью Whisper (рекомендуется): Whisper транскрибирует и переводит аудио за один шаг. Переводит только на английский.
- Писать сразу на нужном языке (язык, экспериментально): Whisper просят сразу писать транскрипцию на этом языке. Для многих языков это работает хорошо, но проверяйте результат.
Google API не умеет переводить. Чтобы позже перевести транскрипцию на любой язык с помощью других поставщиков, используйте кнопку Перевести в транскрипте.
Контекст
Заголовок раздела «Контекст»Два необязательных поля, которые помогают модели:
- Ключевые слова: имена, термины или аббревиатуры, звучащие в записи, через запятую (например,
Audiotext, WhisperX, Henestrosa), чтобы они писались правильно. Это только подсказки: ключевое слово появится, только если оно звучит в записи. - Описание: о чём запись, например её тема или обстановка (например,
Интервью о распознавании речи).
Их используют WhisperX и Whisper API, кроме модели gpt-4o-transcribe-diarize. Google API их не использует.
Параметры
Заголовок раздела «Параметры»- Тайминг слов (WhisperX): выравнивает каждое слово по аудио, чтобы подсвечивать его при воспроизведении и проверять слова, в которых он меньше всего уверен. Занимает немного больше времени. По умолчанию включён. Субтитрам нужны тайминги слов, поэтому параметр включается и блокируется, пока в поле Типы файлов папки выбран
.srtили.vtt; ваш собственный выбор возвращается, когда они больше не выбраны. - Подавить фоновый шум: перед транскрибированием подавляет гул и постоянный фоновый шум и выравнивает тихую речь. Занимает больше времени.
- Определять говорящих (WhisperX): помечает, кто говорит в каждой части, например
SPEAKER_00. Если вы знаете, сколько человек говорит, укажите это в поле Количество говорящих (0— определить автоматически). Нужен бесплатный токен Hugging Face; см. Определение говорящих. В Whisper API говорящих определяет модельgpt-4o-transcribe-diarize.
Определение говорящих
Заголовок раздела «Определение говорящих»Модель, определяющая говорящих, pyannote/speaker-diarization-community-1, бесплатна, но для неё нужен токен Hugging Face:
- Создайте учётную запись на Hugging Face и примите условия pyannote/speaker-diarization-community-1.
- Создайте токен с ролью
Readв своих настройках. - Нажмите Задать токен Hugging Face… и вставьте его.
Модель скачивается при первом использовании. После этого говорящие определяются офлайн.
Живой текст
Заголовок раздела «Живой текст»Показывается только для микрофона. См. Живой текст.
Папка и Вывод
Заголовок раздела «Папка и Вывод»Показываются только для папок:
- Отслеживать папку: см. Отслеживание папки.
- Транскрибировать файлы, которые уже есть в папке (только при отслеживании): сначала транскрибирует файлы, которые уже есть в папке и у которых ещё нет транскрипции. По умолчанию выключено.
- Включать подпапки: транскрибирует и файлы подпапок.
- Пропускать файлы, совпадающие с: имена или пути пропускаемых файлов через запятую (например,
*.wav, drafts/*). Скрытые файлы пропускаются всегда. - Типы файлов: для WhisperX — один или несколько из
.txt,.srt,.vtt,.json,.tsvи.aud. Для Whisper API — формат файлов (text,json,verbose_json,srtилиvtt); для субтитров нужна модель с временными метками. Google API возвращает простой текст (.txt). - Расположение: файлы сохраняются рядом с каждым исходным файлом. Нажмите Изменить…, чтобы сохранять их в другую папку (её подпапки будут воссозданы), или Рядом с источником, чтобы вернуться.
Файлы, у которых уже есть транскрипция, пропускаются. Чтобы транскрибировать их заново, используйте команды файлов папки.
Параметры субтитров (ширина строки, число строк, выделение слов) находятся в Предпочтениях.