

Configuració de la transcripció
Abans de transcriure, Audiotext mostra la configuració de la transcripció, agrupada en targetes. Es recorda per a la propera vegada, i cada transcripció conserva la configuració amb què es va fer.
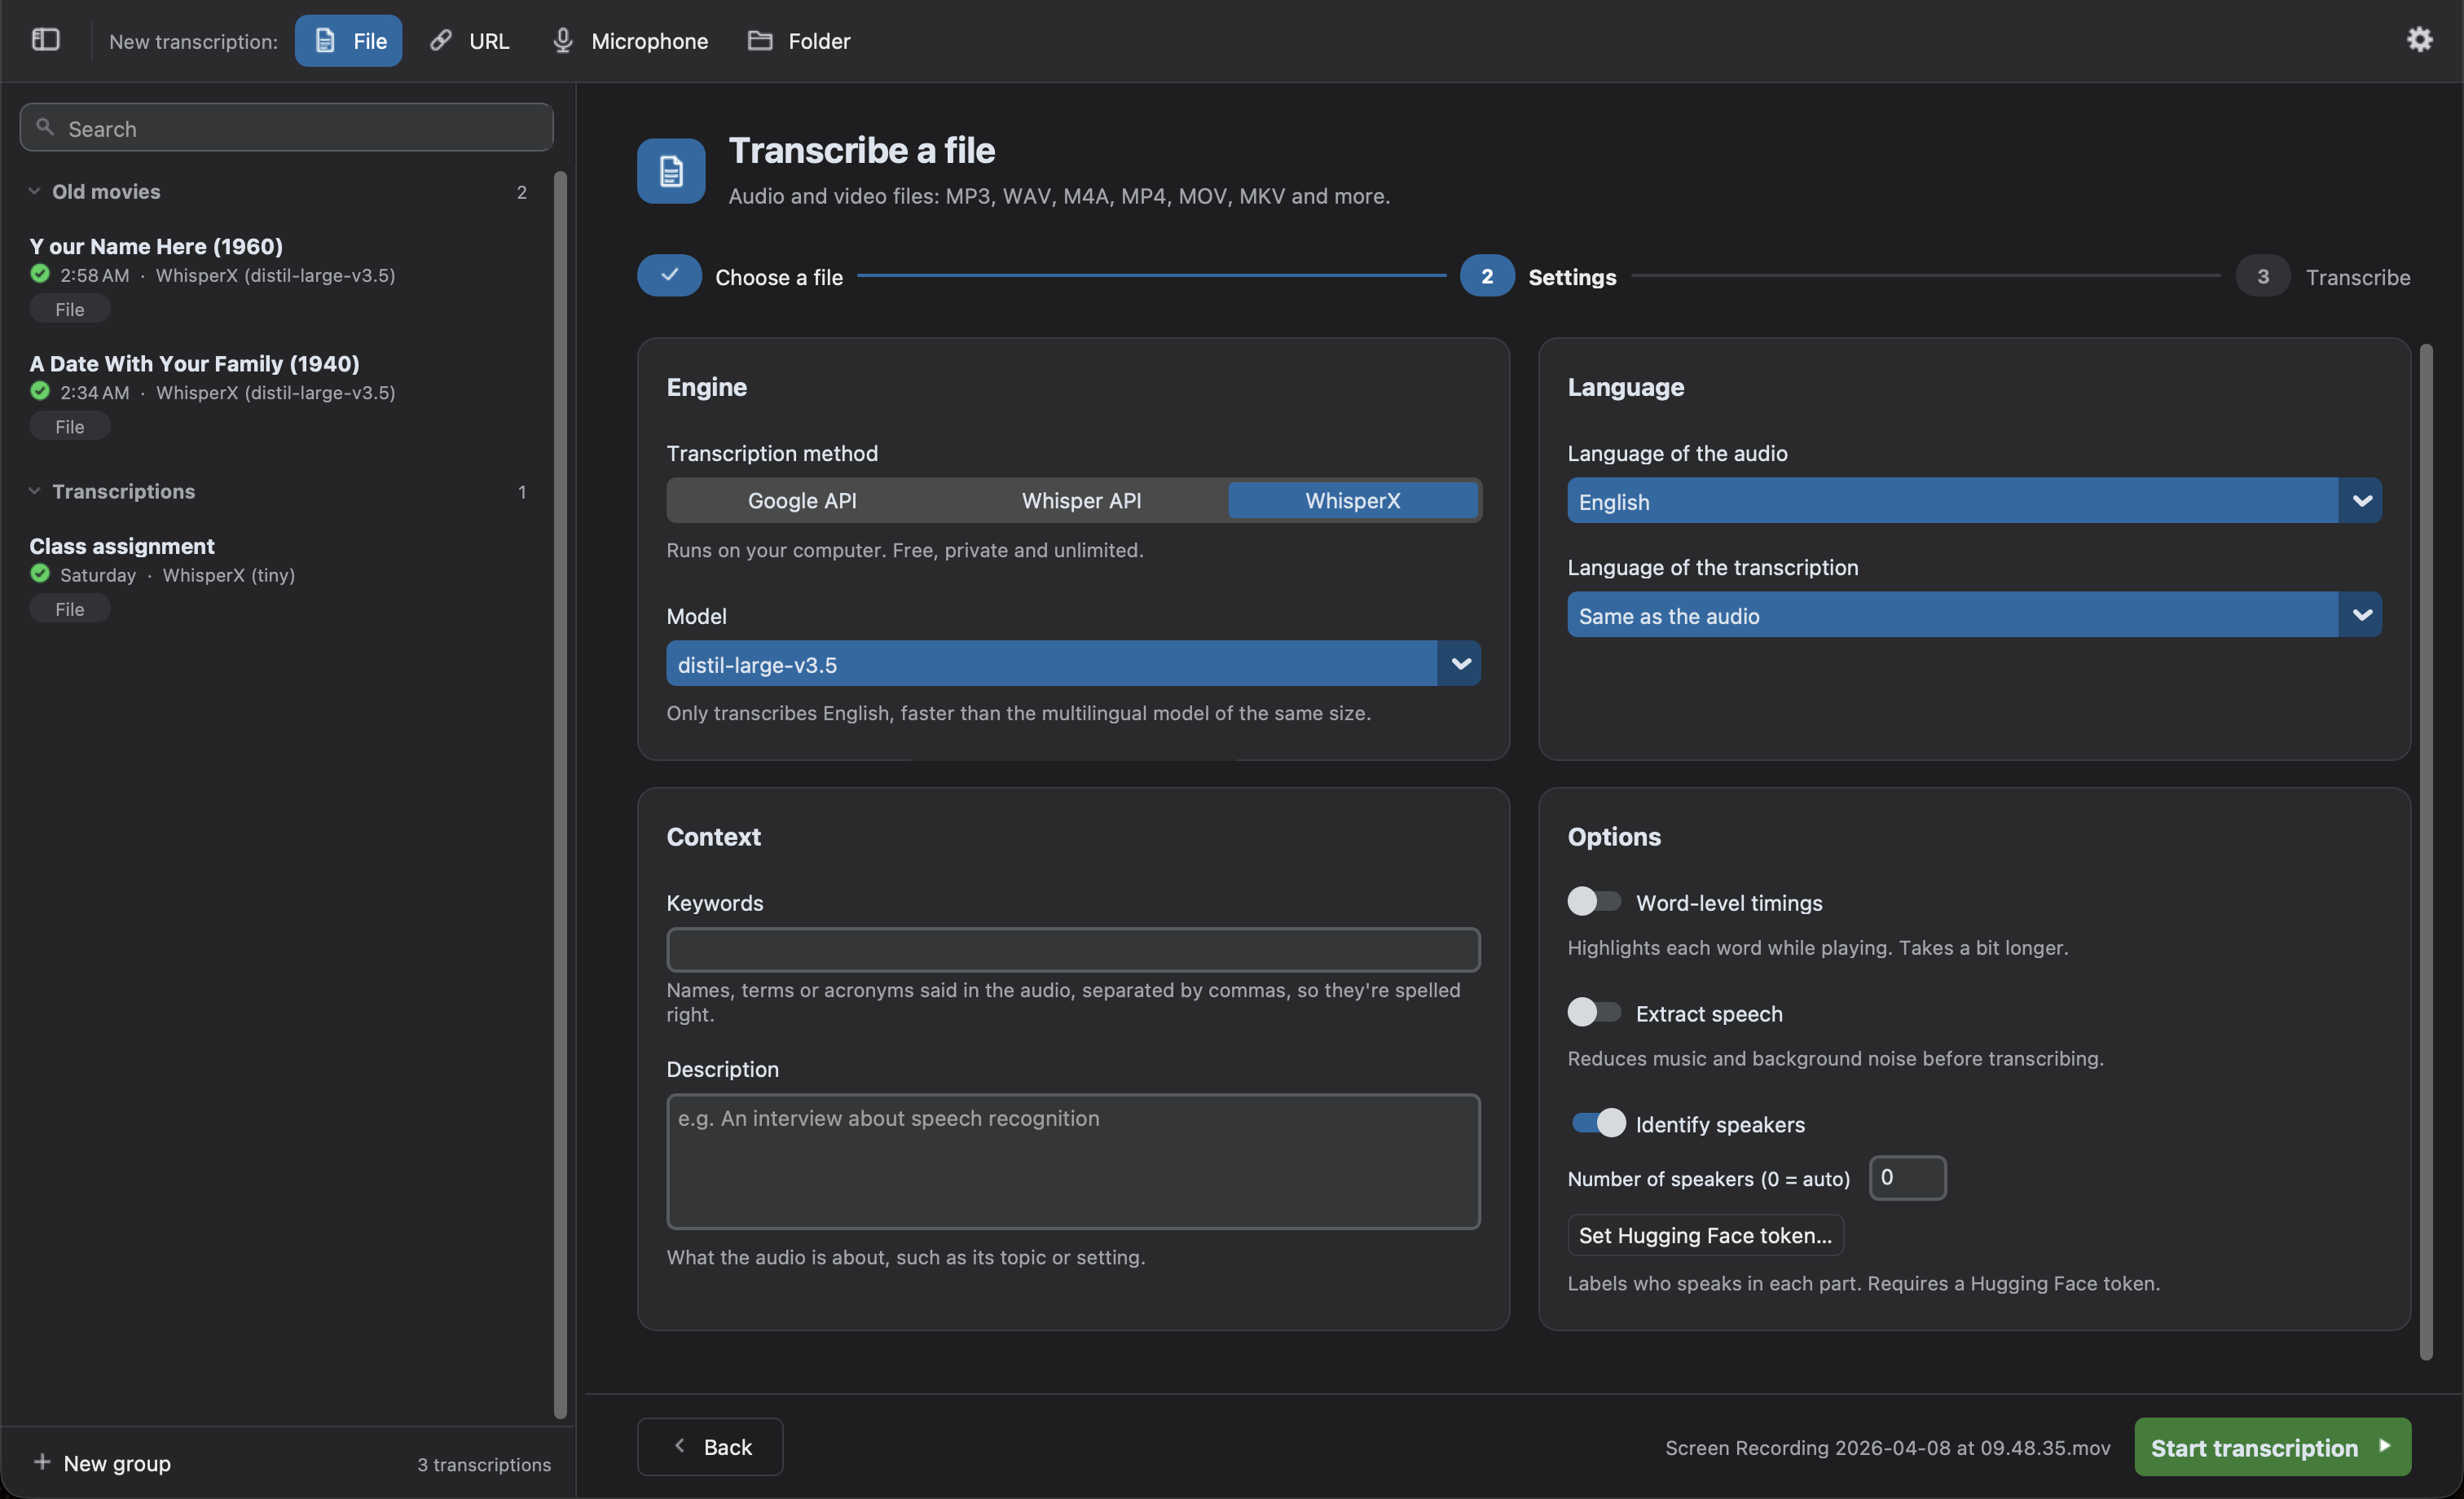
El Mètode de transcripció:
| Motor | On s’executa | Cost | Notes |
|---|---|---|---|
| WhisperX (per defecte) | El teu ordinador | De franc i sense límits | Privat i sense connexió. Més opcions: parlants, temps per paraula, text en directe. Funciona a la GPU dels Mac amb Apple Silicon. |
| API de Whisper | Servidors d’OpenAI | De pagament per minut | Requereix una clau d’API d’OpenAI. Per a ordinadors que no poden executar WhisperX amb fluïdesa. |
| API de Google | Servidors de Google | Gratuïta limitada, o de pagament | Menys qualitat i sense marques de temps. La clau d’API és opcional. |
El Model depèn del motor. Amb WhisperX, els models més grans són més precisos, però més lents. Amb l’API de Whisper, decideix si la transcripció té marques de temps i parlants. Consulta Motors per comparar-los.
Idioma
Section titled “Idioma”- Idioma de l’àudio: Detecció automàtica per defecte. Triar-lo evita errors en àudios curts o barrejats. L’API de Google no el pot detectar, així que l’has de triar.
- Idioma de la transcripció: El mateix que l’àudio per defecte. Tria un altre idioma per traduir l’àudio mentre es transcriu.
Quan els dos idiomes són diferents, apareixen les opcions de Traducció:
- Tradueix amb Whisper (recomanat): Whisper transcriu i tradueix l’àudio en un sol pas. Només pot traduir a l’anglès.
- Escriu-la directament en idioma (experimental): es demana a Whisper que escrigui la transcripció directament en aquell idioma. Funciona bé en molts idiomes, però revisa el resultat.
L’API de Google no pot traduir. Per traduir una transcripció a qualsevol idioma més endavant, amb més proveïdors, fes servir el botó Tradueix de la transcripció.
Context
Section titled “Context”Dos camps opcionals que ajuden el model:
- Paraules clau: noms, termes o sigles que es diuen a l’àudio, separats per comes (p. ex.
Audiotext, WhisperX, Henestrosa), perquè s’escriguin bé. Només són pistes: una paraula clau només s’escriu si es diu a l’àudio. - Descripció: de què tracta l’àudio, com ara el tema o el context (p. ex.
Una entrevista sobre reconeixement de veu).
Els fan servir WhisperX i l’API de Whisper, excepte el model gpt-4o-transcribe-diarize. L’API de Google no els fa servir.
Opcions
Section titled “Opcions”- Temps per paraula (WhisperX): alinea cada paraula amb l’àudio, per ressaltar-la en reproduir i per revisar les paraules de què està menys segur. Triga una mica més. Activat per defecte. Els subtítols necessiten els temps de les paraules, així que s’activa i es bloqueja mentre
.srto.vttestan triats als Tipus de fitxer d’una carpeta; la teva elecció torna quan deixen d’estar-ho. - Reduir el soroll de fons: redueix el brunzit i el soroll de fons constant, i iguala la veu baixa, abans de transcriure. Triga més.
- Identifica els parlants (WhisperX): indica qui parla a cada part, p. ex.
SPEAKER_00. Si saps quantes persones parlen, indica-ho a Nombre de parlants (0ho detecta). Requereix un token gratuït de Hugging Face; consulta Identifica els parlants. Amb l’API de Whisper, el modelgpt-4o-transcribe-diarizeidentifica els parlants.
Identifica els parlants
Section titled “Identifica els parlants”El model que identifica els parlants, pyannote/speaker-diarization-community-1, és gratuït, però requereix un token de Hugging Face:
- Crea un compte a Hugging Face i accepta les condicions de pyannote/speaker-diarization-community-1.
- Crea un token amb el rol
Reada la teva configuració. - Fes clic a Configura el token de Hugging Face… i enganxa’l.
El model es descarrega la primera vegada que es fa servir. Després, els parlants s’identifiquen sense connexió.
Text en directe
Section titled “Text en directe”Només es mostra per al micròfon. Consulta Text en directe.
Carpeta i Sortida
Section titled “Carpeta i Sortida”Només es mostren per a carpetes:
- Vigila la carpeta: consulta Vigila una carpeta.
- Transcriu els fitxers que ja hi ha a la carpeta (només mentre es vigila): primer transcriu els fitxers que ja conté la carpeta i que encara no tenen transcripció. Desactivat per defecte.
- Inclou les subcarpetes: també transcriu els fitxers de les subcarpetes.
- Omet els fitxers que coincideixin amb: noms o camins dels fitxers que s’han d’ometre, separats per comes (p. ex.
*.wav, drafts/*). Els fitxers ocults sempre s’ometen. - Tipus de fitxer: amb WhisperX, un o més de
.txt,.srt,.vtt,.json,.tsvi.aud. Amb l’API de Whisper, el format dels fitxers (text,json,verbose_json,srtovtt); els subtítols necessiten un model amb marques de temps. L’API de Google retorna text pla (.txt). - Ubicació: els fitxers es desen al costat de cada fitxer d’origen. Fes clic a Canvia… per desar-los en una altra carpeta (se’n recreen les subcarpetes), o a Al costat de l’origen per tornar-hi.
Els fitxers que ja tenen una transcripció s’ometen. Per tornar-los a transcriure, fes servir les opcions dels fitxers de la carpeta.
Les opcions dels subtítols (amplada de línia, nombre de línies, paraules ressaltades) són a les Preferències.