

Configurações da transcrição
Antes de transcrever, o Audiotext mostra as configurações da transcrição, agrupadas em cartões. Elas são lembradas para a próxima vez, e cada transcrição guarda as configurações com que foi feita.
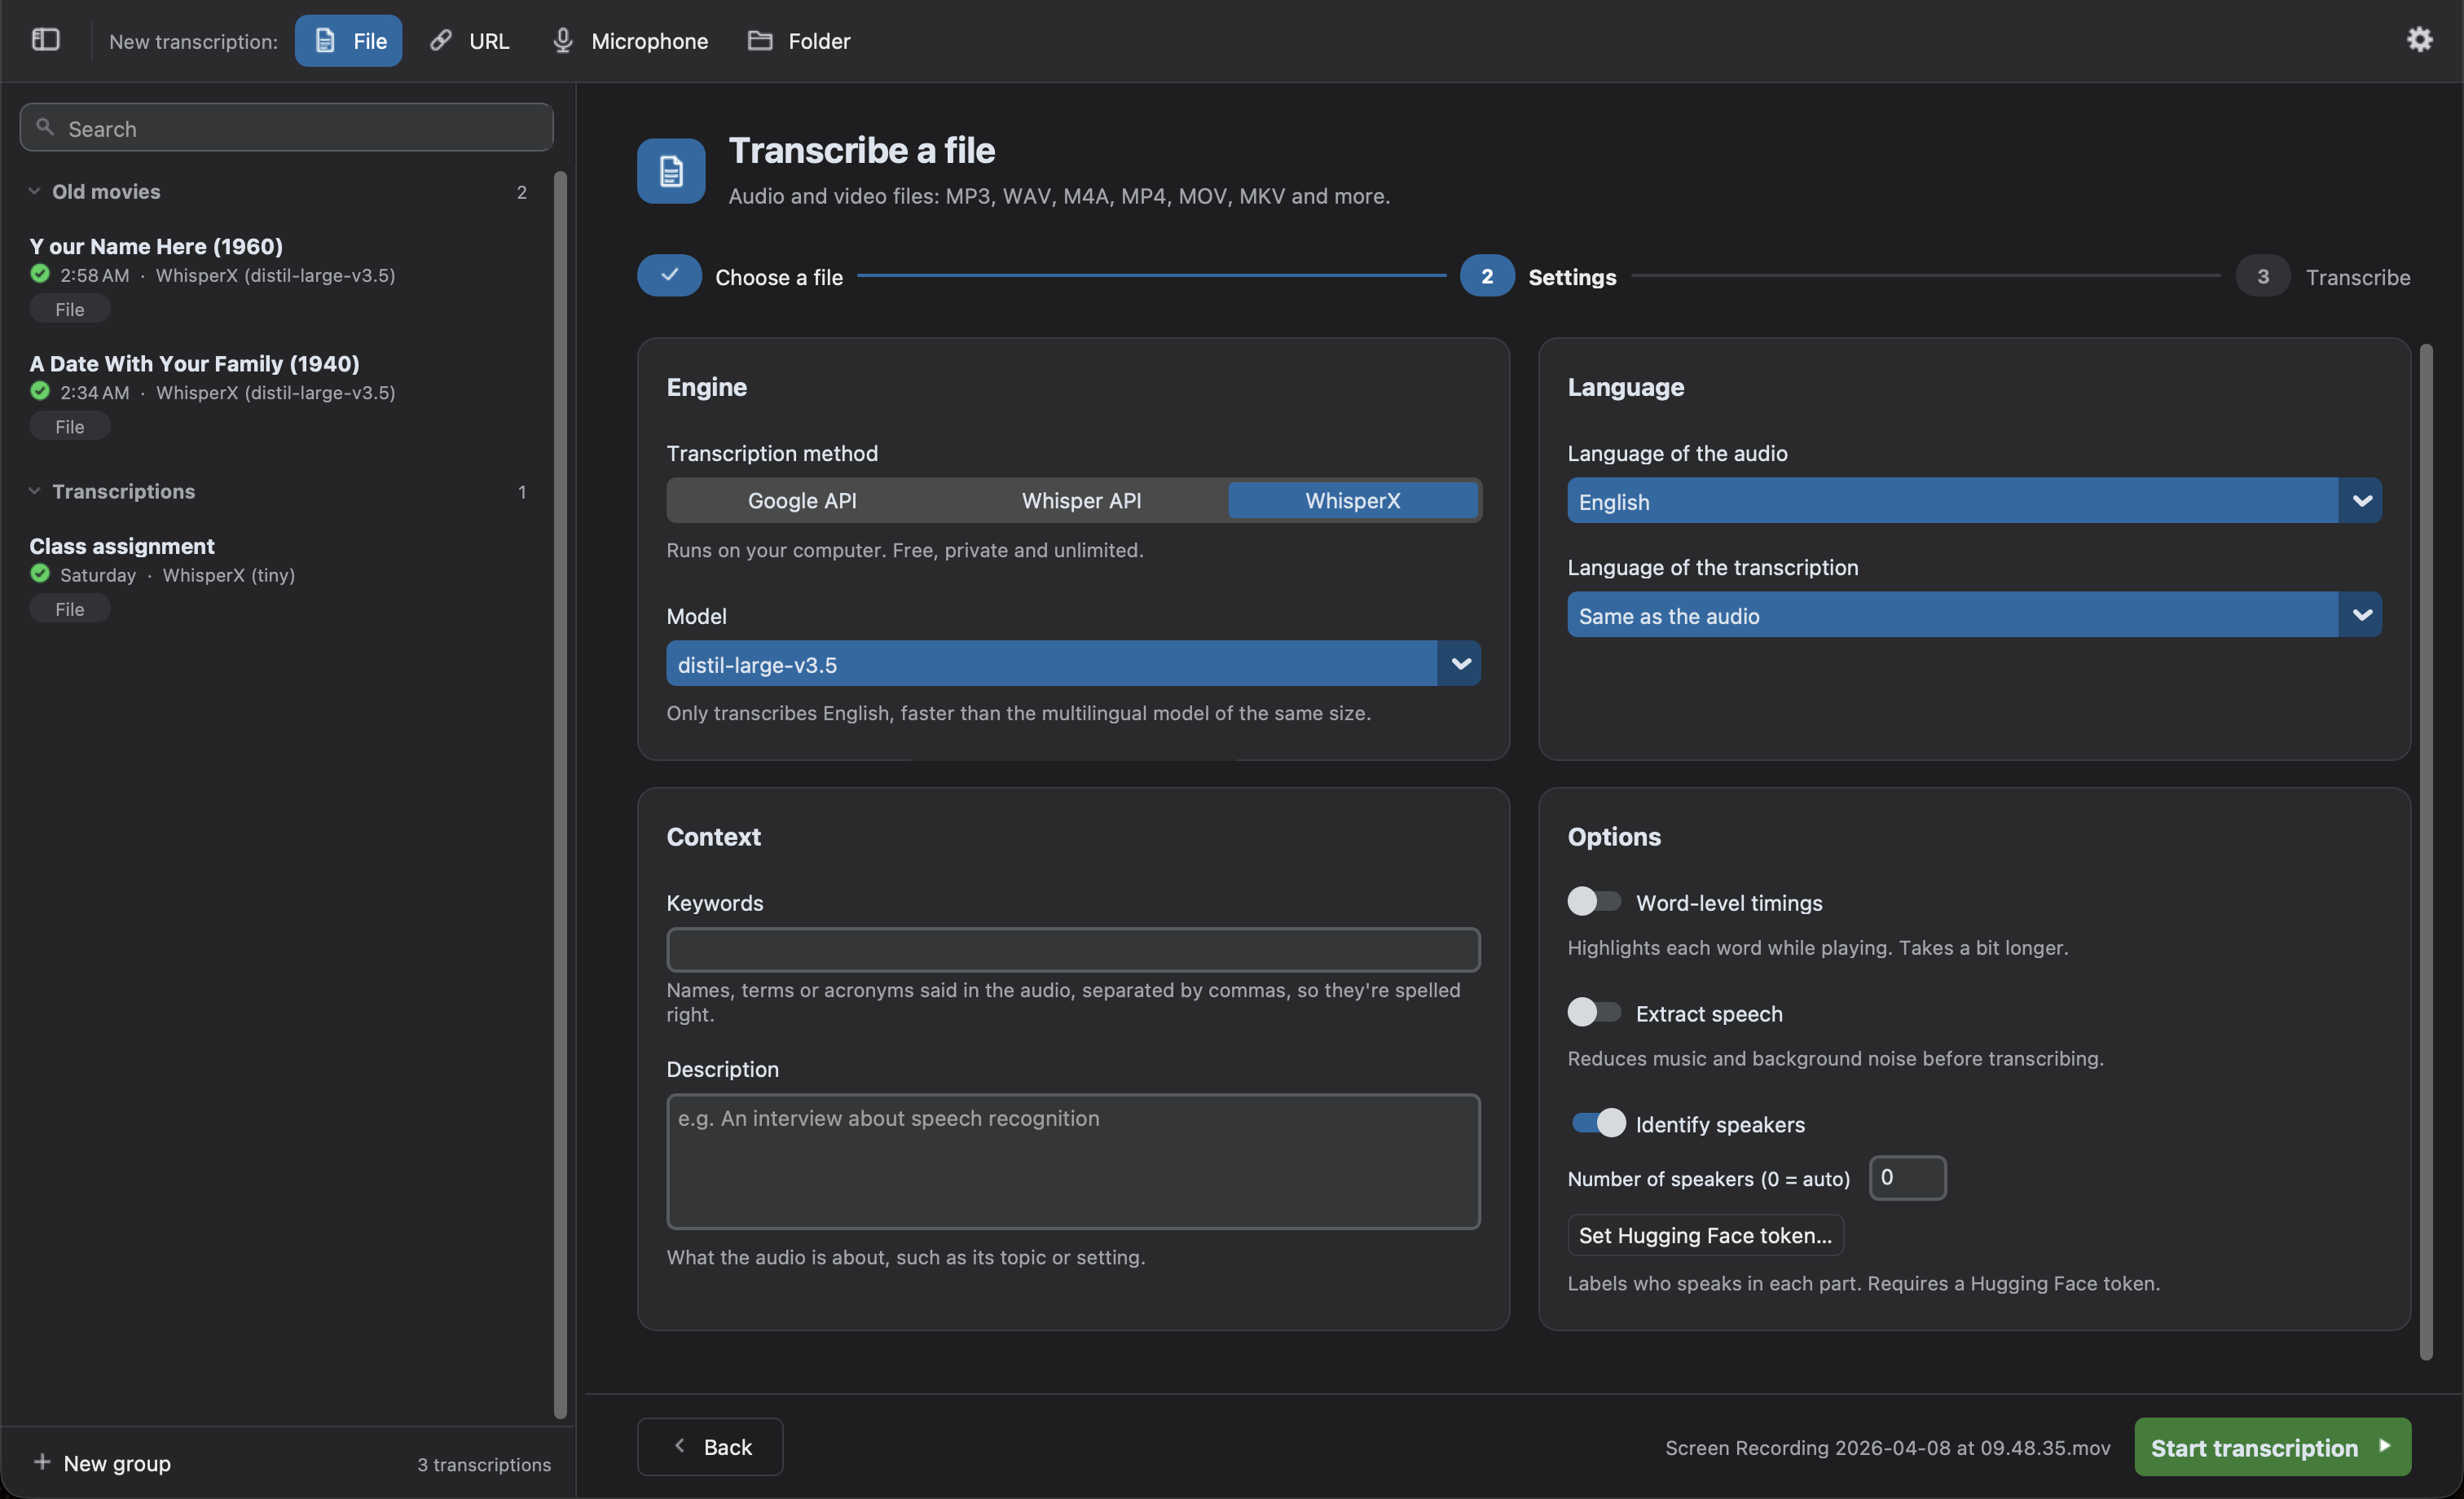
Mecanismo
Seção intitulada “Mecanismo”O Método de transcrição:
| Mecanismo | Onde roda | Custo | Observações |
|---|---|---|---|
| WhisperX (padrão) | Seu computador | Grátis e ilimitado | Privado e offline. Mais opções: falantes, tempos por palavra, texto ao vivo. Roda na GPU dos Macs com Apple Silicon. |
| API do Whisper | Servidores da OpenAI | Pago por minuto | Exige uma chave de API da OpenAI. Para computadores que não rodam o WhisperX com fluidez. |
| API do Google | Servidores do Google | Camada gratuita, ou pago | Qualidade menor e sem carimbos de tempo. A chave de API é opcional. |
O Modelo depende do mecanismo. Com o WhisperX, os modelos maiores são mais precisos, porém mais lentos. Com a API do Whisper, ele define se a transcrição tem carimbos de tempo e falantes. Consulte Mecanismos para compará-los.
- Idioma do áudio: Detectar automaticamente por padrão. Escolhê-lo evita erros em áudios curtos ou misturados. A API do Google não consegue detectá-lo, então você precisa escolhê-lo.
- Idioma da transcrição: O mesmo do áudio por padrão. Escolha outro idioma para traduzir o áudio durante a transcrição.
Quando os dois idiomas são diferentes, aparecem as opções de Tradução:
- Traduzir com o Whisper (recomendado): o Whisper transcreve e traduz o áudio em uma única etapa. Ele só traduz para o inglês.
- Escrevê-la diretamente em idioma (experimental): o Whisper é instruído a escrever a transcrição diretamente nesse idioma. Funciona bem em muitos idiomas, mas confira o resultado.
A API do Google não traduz. Para traduzir uma transcrição para qualquer idioma depois, com mais provedores, use o botão Traduzir da transcrição.
Contexto
Seção intitulada “Contexto”Dois campos opcionais que ajudam o modelo:
- Palavras-chave: nomes, termos ou siglas ditos no áudio, separados por vírgulas (ex.:
Audiotext, WhisperX, Henestrosa), para que sejam escritos corretamente. São só dicas: uma palavra-chave só é escrita se for dita no áudio. - Descrição: do que o áudio trata, como o tema ou o contexto (ex.:
Uma entrevista sobre reconhecimento de fala).
Eles são usados pelo WhisperX e pela API do Whisper, exceto pelo modelo gpt-4o-transcribe-diarize. A API do Google não os usa.
- Tempos por palavra (WhisperX): alinha cada palavra ao áudio, para destacá-la durante a reprodução e para revisar as palavras de que tem menos certeza. Demora um pouco mais. Ativado por padrão. As legendas precisam dos tempos das palavras, então ela é ativada e bloqueada enquanto
.srtou.vttestiverem escolhidos nos Tipos de arquivo de uma pasta; a sua escolha volta quando deixam de estar. - Reduzir o ruído de fundo: reduz o zumbido e o ruído de fundo constante, e equilibra a fala baixa, antes de transcrever. Demora mais.
- Identificar falantes (WhisperX): indica quem fala em cada parte, ex.:
SPEAKER_00. Se você souber quantas pessoas falam, informe em Número de falantes (0detecta automaticamente). Exige um token gratuito do Hugging Face; consulte Identifique os falantes. Com a API do Whisper, o modelogpt-4o-transcribe-diarizeidentifica os falantes.
Identifique os falantes
Seção intitulada “Identifique os falantes”O modelo que identifica os falantes, pyannote/speaker-diarization-community-1, é gratuito, mas exige um token do Hugging Face:
- Crie uma conta no Hugging Face e aceite as condições do pyannote/speaker-diarization-community-1.
- Crie um token com a função
Readnas suas configurações. - Clique em Definir token do Hugging Face… e cole-o.
O modelo é baixado na primeira vez que é usado. Depois disso, os falantes são identificados offline.
Texto ao vivo
Seção intitulada “Texto ao vivo”Só aparece para o microfone. Consulte Texto ao vivo.
Pasta e Saída
Seção intitulada “Pasta e Saída”Só aparecem para pastas:
- Monitorar a pasta: consulte Monitore uma pasta.
- Transcrever os arquivos que já estão na pasta (só ao monitorar): transcreve primeiro os arquivos que a pasta já contém e que ainda não têm transcrição. Desativado por padrão.
- Incluir subpastas: também transcreve os arquivos das subpastas.
- Ignorar arquivos que correspondam a: nomes ou caminhos dos arquivos a ignorar, separados por vírgulas (ex.:
*.wav, drafts/*). Os arquivos ocultos são sempre ignorados. - Tipos de arquivo: com o WhisperX, um ou mais entre
.txt,.srt,.vtt,.json,.tsve.aud. Com a API do Whisper, o formato dos arquivos (text,json,verbose_json,srtouvtt); as legendas exigem um modelo com carimbos de tempo. A API do Google retorna texto simples (.txt). - Local: os arquivos são salvos ao lado de cada arquivo de origem. Clique em Alterar… para salvá-los em outra pasta (as subpastas são recriadas), ou em Ao lado da origem para voltar.
Os arquivos que já têm uma transcrição são ignorados. Para transcrevê-los de novo, use as opções dos arquivos da pasta.
As opções das legendas (largura da linha, número de linhas, palavras destacadas) ficam nas Preferências.